LongCat 2.5 基準全盤點:官方 31 項、DeepSeek 同價之爭
LongCat 2.5 的 31 項官方基準全部來自美團自測——博客評測表與 Hugging Face README 表完全一致,對手分數一半引自公開報告、一半美團自跑。表內亮點是 BrowseComp 91.9 與 3DCodeBench 55.4 兩項第一,但同價的 DeepSeek V4.1 Flash 在多數編碼行上領先;截至 11 月 13 日,沒有任何獨立機構給 2.5 打過分。下面逐項拆開。
31 項基準:三類全覽
31 項分三類:Code Agent 10 項、General Agent 14 項、Visual 7 項。表內第一共四項:BrowseComp 91.9、3DCodeBench 55.4、ALE 38.5 與 ResearchRubrics 81.0。下表列出主要分數,每行附 2.0 對照與主要對手對照;帶 * 的對手分數引自公開報告或榜單,不帶 * 的爲美團自跑。
| 基準 | LongCat 2.5 | LongCat 2.0 | 主要對手 |
|---|---|---|---|
| Terminal-Bench v2.1 | 88.4 | 70.8 | DeepSeek 90.6*、Opus 5 89.1* |
| Terminal-Bench v4.0 | 38.5 | 3.0 | Opus 5 53.9*、GLM 41.8* |
| DeepSWE v1.1 | 64.6 | 9.7 | DeepSeek 74.2*、Sol 72.7* |
| ProgramBench | 25.5 | 2.5 | Opus 5 37.0*、Sol 23.0* |
| PaperBench | 82.1 | 45.2 | Sol 83.3、GPT-5.5 80.0 |
| NL2Repo | 60.5 | 40.9 | Opus 5 75.3*、DeepSeek 65.4* |
| BrowseComp | 91.9(表內第一) | 79.9 | DeepSeek 91.5、K3 91.2* |
| HLE(帶工具) | 63.1 | 37.5 | Opus 5 64.7*、DeepSeek 63.9* |
| MCP Atlas | 83.1 | 61.8 | Opus 5 85.8*、DeepSeek 84.4 |
| AutomationBench v1.0.6 | 51.8 | 15.8 | DeepSeek 54.8*、Opus 5 50.3* |
| JobBench | 65.4 | 44.4 | Opus 5 66.7*、DeepSeek 63.2 |
| 3DCodeBench(文本→3D) | 55.4(表內第一) | —(2.0 無視覺能力) | Opus 5 54.3、GLM 53.4 |
| VideoMME | 85.2 | —(2.0 無視覺能力) | K3 90.0*、Sol 89.5* |
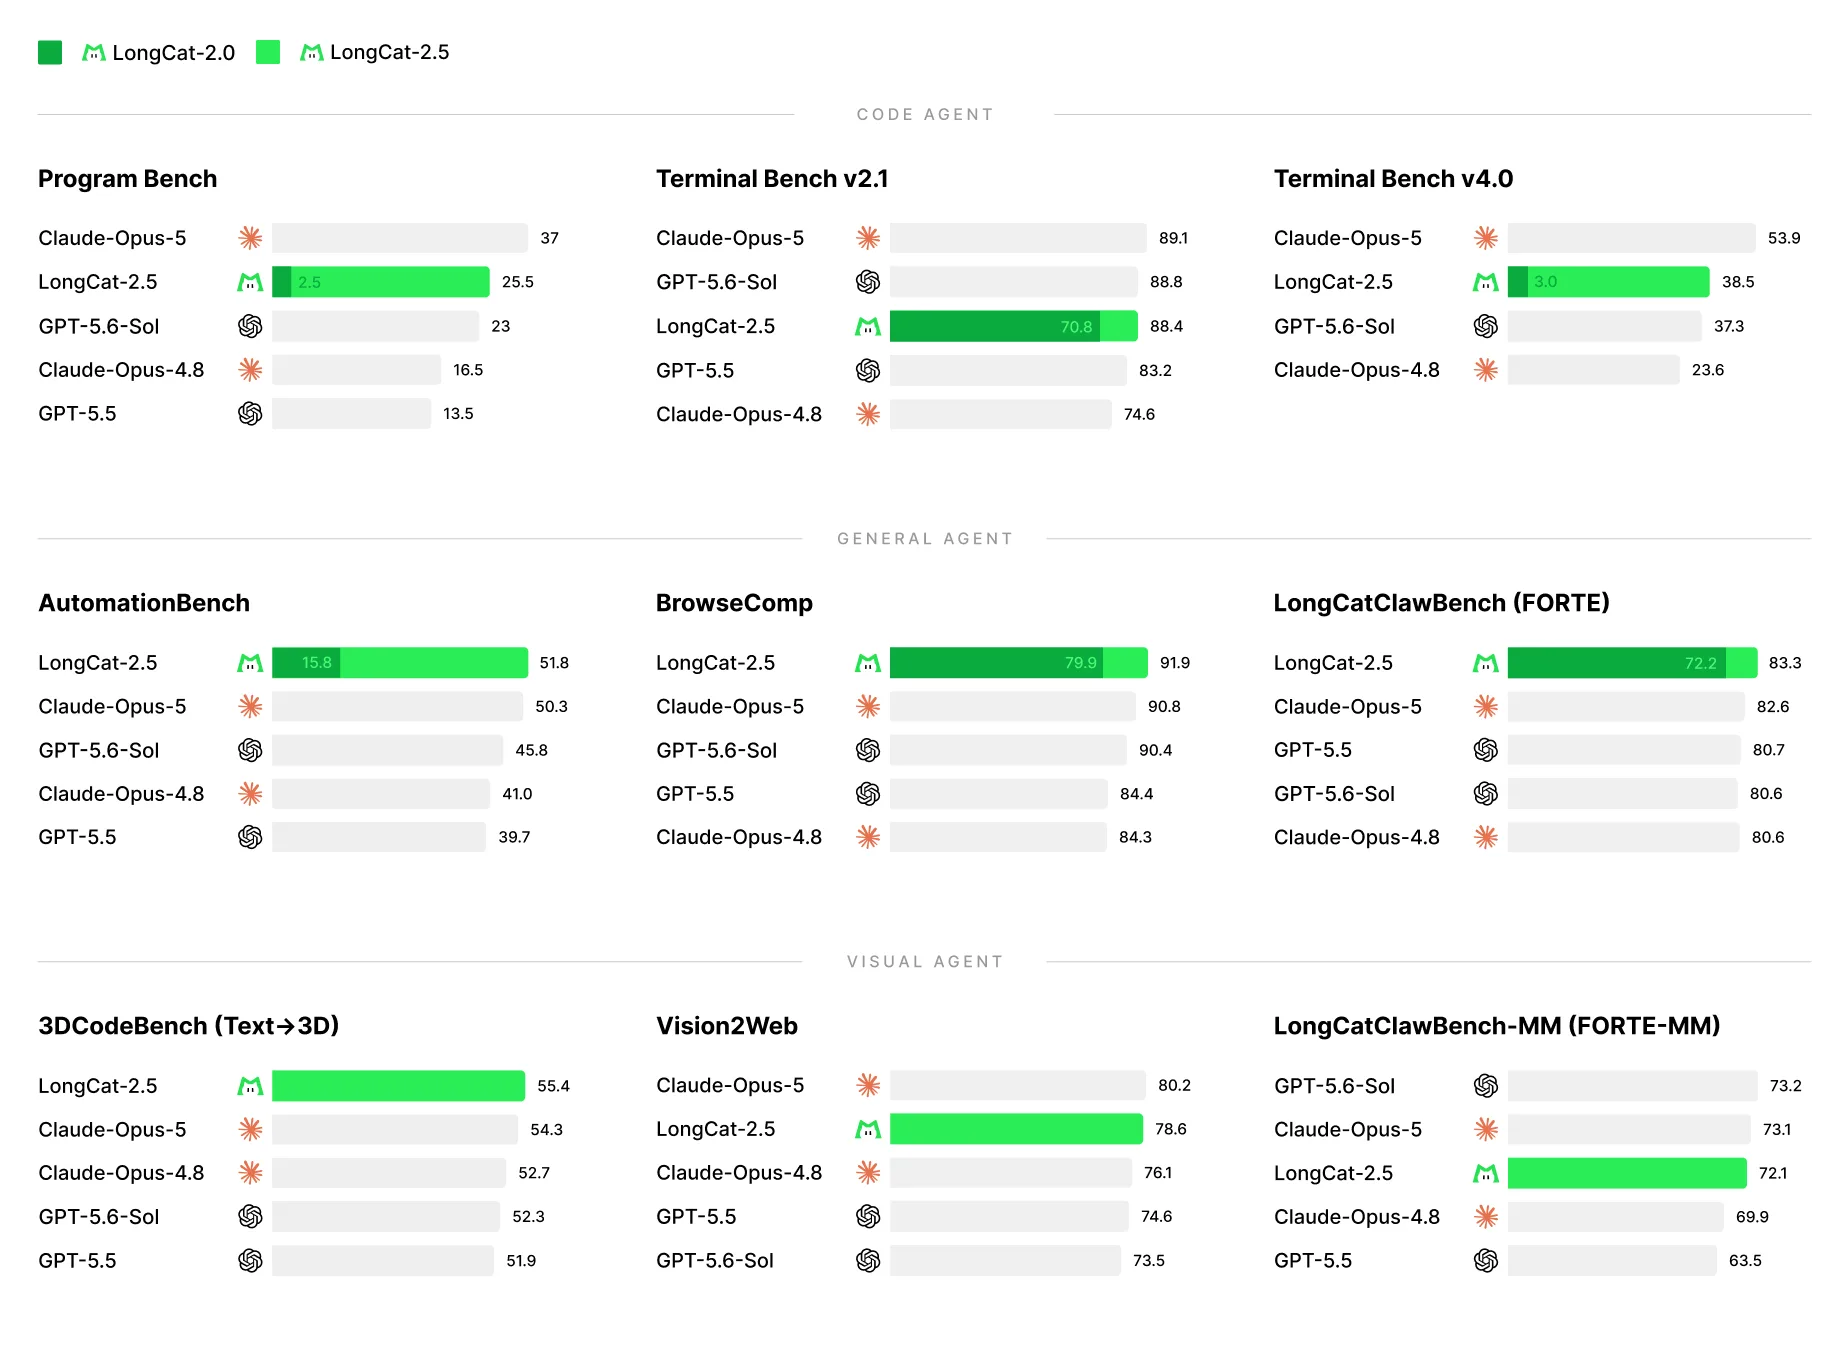
表外值得一提的還有:SWE Atlas 三項(代碼庫問答 58.3、重構 55.2、測試編寫 47.8)、SkillsBench 63.3、GDPVal-AA 84.8、FrontierScience 77.0、FinSearchComp T3 63.4,以及視覺類的 Vision2Web 78.6、CharXiv-RQ 90.2、MathVision 96.5 與 PosterBench 77.4。整體看,2.5 的強項集中在長程 Agent 與搜索類任務,純編碼與視覺問答上與前沿閉源模型仍有距離。
測試條件:這些分數是怎麼跑出來的
統一條件是思考模式開、temperature 1.0、top_p 0.95。Terminal-Bench 用 Claude Code harness v2.1.280(max_seq 512K,v2.1 爲三次平均);DeepSWE 用 mini-swe-agent(1M 序列,三次平均);BrowseComp 是美團自定義的輕量 harness,只有 search 與 browse_with_goal 兩個工具,最多 1024 輪——這意味着 BrowseComp 91.9 的第一名含金量要打折扣,它不是標準 BrowseComp 口徑。對手分數帶 * 的引自公開報告或榜單,不帶 * 的是美團自跑、官方口徑爲「僅供參考」。
同價之爭:DeepSeek V4.1 Flash 對照
兩者限時價完全相同($0.30/$1.20),對照最有意義。按美團表內,DeepSeek 領先的行更多:TB 2.1(90.6 vs 88.4)、DeepSWE(74.2 vs 64.6)、NL2Repo(65.4 vs 60.5)、AutomationBench(54.8 vs 51.8)、MCP Atlas(84.4 vs 83.1)、SkillsBench(69.8 vs 63.3)與 SWE Atlas 重構(56.7 vs 55.2)。LongCat 領先的行有四處:TB 4.0(38.5 vs 31.2)、BrowseComp(91.9 vs 91.5)、ProgramBench(25.5 vs 20.3)與 SWE Atlas 問答(58.3 vs 55.2);VideoMME 只有 LongCat 公佈了分數(85.2)。
格局很清楚:DeepSeek 在傳統編碼任務上佔優,LongCat 在新版長程基準(TB 4.0、ProgramBench)與搜索類任務上反超。注意這仍是美團自家的表——DeepSeek 的分數帶 *,引自公開報告,不是同一 harness 下的同場跑分。
躍升、缺失與對照集偏舊
2.0 到 2.5 的躍升幅度是這張表最真實的部分:TB 4.0 從 3.0 升至 38.5,DeepSWE 從 9.7 升至 64.6,ProgramBench 從 2.5 升至 25.5,HLE(帶工具)從 37.5 升至 63.1,AutomationBench 從 15.8 升至 51.8,MCP Atlas 從 61.8 升至 83.1。長程 RL 的投入在這些行上兌現了。
但獨立測量仍然缺失。Artificial Analysis 未收錄 2.5,榜單上只有 2.0 與 LongCat Flash Lite;ArtificialWatch 11 月 13 日發文稱「not rated yet」,llmperks 的 AA Index 欄爲「—」。口徑警示來自 2.0:AA 測得 2.0 的 TB 2.1 爲 50.2%,而美團表內 2.0 爲 70.8——同一模型、不同 harness,相差 20 分。2.5 的廠商分數也應按此打折理解。社區只有一位開發者用免費預覽版自跑 TB 2.1 得 48.7%(單人、預覽版、不同 harness),僅作參考,不能當作 2.5 的分數。
對照集也偏舊:官方儀表盤圖裏沒有 Opus 5.5、GPT-6.1 Sol 與 Kimi K3.1 Pro,eesel 與 Hacker News 都指出了這一點。讀這張表時,缺席的對手和在場的對手一樣值得注意。
參考來源:APIYI — LongCat 2.5 官方基準與價格指南(本文爲本站改寫與整理,事實以官方來源爲準)