美團 LongCat 2.5 專題
美團 LongCat 團隊 2026 年 11 月 2 日 GA 的最新一代模型:1.6T 總參數 MoE,約 48B 激活,原生多模態(文本 + 圖像 + 視頻輸入),爲長程 Agent 任務訓練,1M 上下文。限時價 $0.30/$1.20 與 DeepSeek V4.1 Flash 完全相同,官方自報 Terminal-Bench 2.1 88.4 分;但截至 11 月 13 日沒有任何獨立機構評分,折扣既無截止日期也無目錄價,而權重已在 11 月 4 日悄然 MIT 開源——11 月初的大多數報道都還沒跟上這一變化。本頁彙總官方規格、上手路線、價格與中英文首批解讀,並明確標註哪些說法尚未證實。
01關鍵事實
先把能確認的說清楚:這是個 1.6T 參數的原生多模態 Agent 模型,定價與 DeepSeek V4.1 Flash 針鋒相對,權重已經 MIT 開源——但所有亮眼分數都來自廠商自測,獨立驗證一張都沒有。
- 發佈
- 2026-11-02 GA(LongCat API Platform 上線;技術博客 11 月 1 日官宣,預覽版 9 月 25 日)。本站以 11 月 2 日爲發佈日:那是它實際可用的第一天。
- 開發方
- 美團 LongCat 團隊,中國美團旗下大模型團隊
- 架構
- 稀疏 MoE;1.6T 總參數,每 token 激活約 48B(權重倉庫 config.json:38 層,768 路由專家,top-12 路由,MLA 注意力,詞表 163,840)
- 上下文
- 1M tokens(API 口徑 1,048,576,輸入 + 輸出合計);config 基數 524,288,經 YaRN 擴展;最大輸出 128K(文檔口徑不一,見第 09 節)
- 輸入 / 輸出
- 輸入:文本、圖像、視頻;輸出:文本。思考模式經 reasoning_content 字段返回;溫度固定(思考開 1.0、關 0.7,傳入其它值會被靜默覆蓋)
- 新能力
- 原生多模態視覺(多層離散 token,無獨立視覺編碼器);視頻理解隨 GA 加入;長程 Agent 訓練(F2P/P2P 強化學習、MOPD 多教師蒸餾)
- 價格
- 限時折扣:輸入 $0.30 / 緩存輸入 $0.006 / 輸出 $1.20(每百萬 tokens;人民幣 ¥2 / ¥0.04 / ¥8);無截止日期、無目錄價,官方稱「價格可能變動」
- 基準分
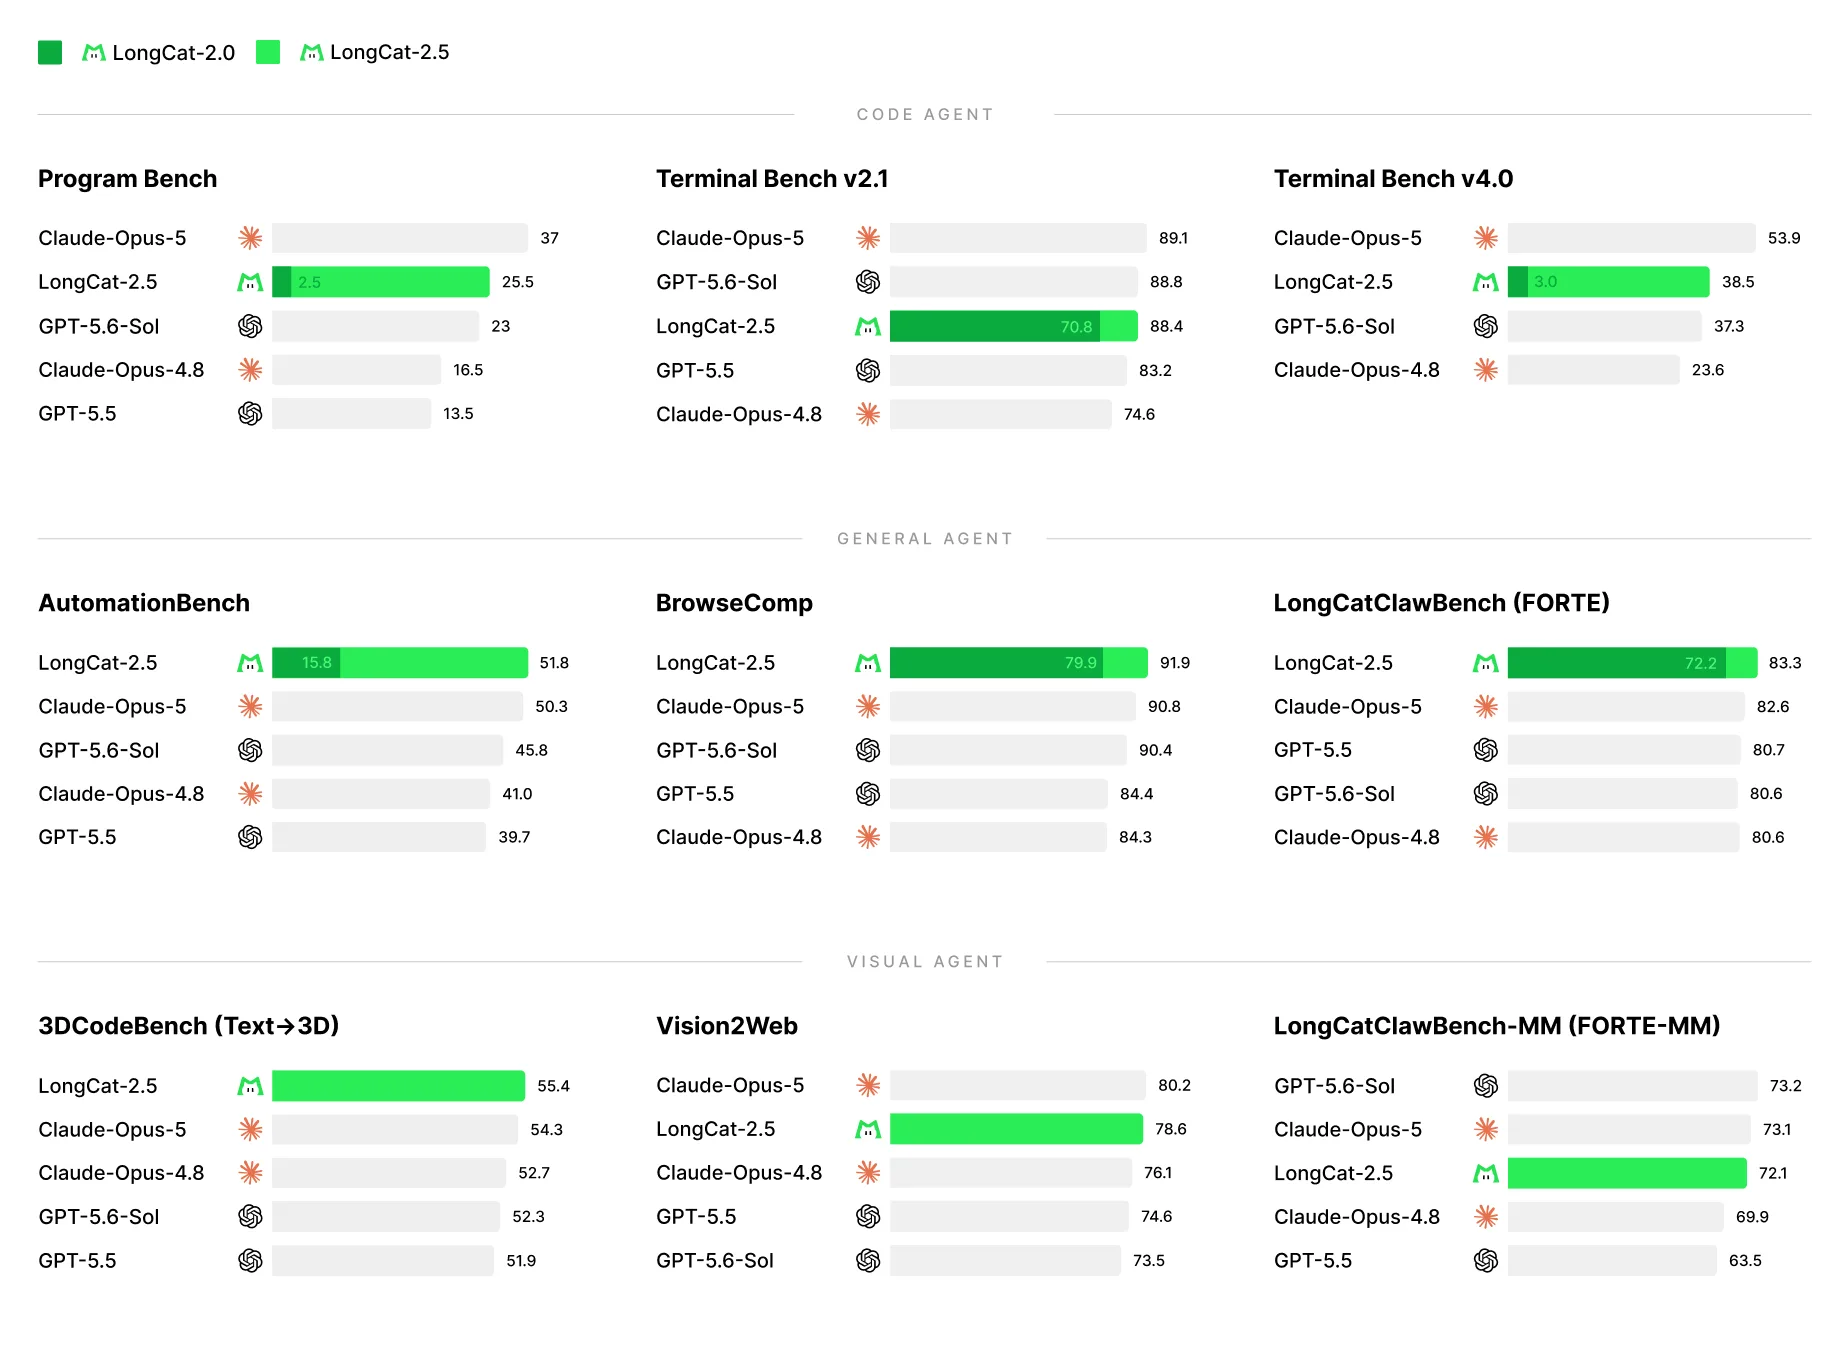
- 官方自報 31 項:Terminal-Bench 2.1 88.4、DeepSWE 64.6、BrowseComp 91.9(表內第一)、3DCodeBench 55.4(表內第一);獨立評分:暫無(Artificial Analysis 尚未收錄,截至 11 月 13 日)
- 權重
- 已發佈(2026-11-04,MIT 協議;全量 3,317.3 GB,W4A4 量化版 1,244.3 GB;Hugging Face,另有 ModelScope 鏡像)
- 可用渠道
- longcat.ai/chat、LongCat API Platform(模型 ID
LongCat-2.5)、Vercel AI Gateway、AnyRouter、OpenCode(Zen 免費版)、Nous Portal;不在 OpenRouter(11 月 13 日覈查) - 前代
- LongCat 2.0(2026-06-30 GA,MIT 權重);2.5 與 2.0 同款底座 + 視覺與 Agent 訓練
- 知識截止
- 未見官方公佈
02時間線
從 2.0 到 2.5 只隔了四個月:預覽、官宣、GA、權重開源在七週內走完——權重上架甚至沒等一篇正式公告。
- 2026-04-20
LongCat 2.0 預覽版發佈:純文本 Agent 模型,1M 上下文。
- 2026-06-30
2.0 GA 並 MIT 開源權重(Hugging Face 建倉 7 月 5 日);當時的目錄價爲 $0.75 / $0.015 / $2.95。
- 2026-09-25
LongCat 2.5 預覽版發佈:純文本,視覺能力尚未開放;社區自測預覽版 Terminal-Bench 2.1 約 48.7%(單人、不同 harness,僅作參考)。
- 2026-11-01
技術博客官宣 LongCat 2.5:公佈 1.6T 參數、原生多模態架構與 31 項官方基準;權重標註 "coming soon"。
- 2026-11-02
GA 上線 LongCat API Platform:視頻理解隨 GA 加入;限時價 $0.30/$1.20 同日生效。同日美團技術團隊博客公佈訓練方法(國產加速器、W4A4、長程 RL)。
- 2026-11-04
權重悄然上架 Hugging Face:全量 + W4A4 兩個倉庫,MIT 協議,無正式公告;Nous Portal 同日上線免費端點。
- 2026-11-09
OpenCode Zen 推出免費版
longcat-2.5-free;付費版隨 OpenCode Go 提供。 - 2026-11-13
Artificial Analysis 仍未收錄(ArtificialWatch 當日報告 "not rated yet");本站專題上線。
03官方規格
以下爲官方已公佈口徑(技術博客、API 平臺文檔與 Hugging Face 權重倉庫 config.json,2026 年 11 月 13 日覈查)。注意:最大輸出與上下文各有兩個口徑,見正文與第 09 節。
- 狀態
- 已發佈(2026-11-02 GA);權重已發佈(2026-11-04)
- 模型 ID
- LongCat-2.5
- 架構
- 稀疏 MoE;1.6T 總參數,約 48B 激活;38 層,768 路由專家,top-12 路由,MLA 注意力,詞表 163,840
- 上下文窗口
- 1M tokens(API 口徑 1,048,576,輸入 + 輸出合計;config 基數 524,288,經 YaRN rope scaling 擴展)
- 最大輸出
- 128K tokens(Quick Start、FAQ 與美團 Claude Code 配置口徑;Model Parameters 頁稱 max_tokens 可至 262,144——文檔口徑不一,按 128K 規劃)
- 輸入
- 文本、圖像(PNG/JPG/JPEG/WebP/GIF,≤10MB,≤50/請求)、視頻(≤100MB,<3600 秒,≤10/請求,僅公開 URL;不支持 SVG/HEIC,長寬比 >200:1 報錯)
- 輸出
- 文本
- 思考模式
- 經 reasoning_content 字段返回;溫度固定(思考開 1.0、關 0.7)
- API 協議
- OpenAI Chat Completions、OpenAI Responses(供 Codex,effort none 至 xhigh)、Anthropic Messages;端點 api.longcat.chat
- 訓練
- 國產加速器(<80GB 顯存)訓練;W4A4 量化推理;長程 RL(F2P/P2P,防獎勵作弊);MOPD 多教師蒸餾
- 基準分
- 官方自報 31 項(見第 06C 節);獨立評分暫無
- 權重
- MIT;全量 3,317.3 GB(210 個分片)、W4A4 1,244.3 GB(208 個分片)
- 許可
- MIT
- API 價格
- $0.30 輸入 / $0.006 緩存 / $1.20 輸出(限時折扣,無截止日期)
04怎麼試用:6 條路線
權重已開源,但 3.3TB 的體積與 NPU 導向的部署指引意味着多數人還是走託管 API。最快的是 OpenCode 免費版與 Nous Portal 的免費端點。
1LongCat API Platform(官方主路線)
美團官方 API 平臺,模型 ID LongCat-2.5。OpenAI 與 Anthropic 雙協議兼容,端點 api.longcat.chat;預付餘額永不過期,僅 HTTP 200 請求計費。郵箱註冊,中國大陸外無需身份覈驗;USD 站支持信用卡、借記卡與 Google Pay。官方提供 13 份工具接入指南(Claude Code、Codex、OpenCode、Cline、Kilo Code、Hermes、OpenClaw 等)。
2longcat.ai/chat(官方聊天應用)
官方聊天入口,登錄後直接使用;回覆默認中文。有社區反饋稱登錄會跳轉到另一域名,體驗上略有割裂。
3網關:Vercel AI Gateway、AnyRouter
2.5 已接入 Vercel AI Gateway 與 AnyRouter,適合已有網關賬單的開發者統一調用。注意:不在 OpenRouter(11 月 13 日經 OpenRouter API 覈查,僅有 meituan/longcat-2.0);APIYI 已宣佈計劃接入,截至 11 月 3 日尚未上線。
4OpenCode Zen 免費版
11 月 9 日起,OpenCode Zen 提供免費版 longcat-2.5-free;付費版隨 OpenCode Go 提供。適合編碼 Agent 場景零成本試用。
5Nous Portal 免費端點
11 月 4 日上線免費端點,另一條零成本試用路線。
6本地部署(權重已開源)
Hugging Face 兩個倉庫均可下載:全量 3,317.3 GB(210 分片)與 W4A4 1,244.3 GB(208 分片),MIT 協議,另有 ModelScope 鏡像。README 只指引 NPU + 美團 SGLang-FluentLLM 分支部署;vLLM 支持未見官方說明(未證實),官方也未公佈自託管的 VRAM 需求——不要按 3.3TB 體積自行推算顯卡數。
05價格解析
限時價與 DeepSeek V4.1 Flash 高峯價一分不差——這是有意爲之的同價對位。但折扣沒有截止日期、沒有目錄價,長期預算沒法按這個價鎖定。價格爲 2026 年 11 月 13 日覈查口徑,結賬頁價格爲準。
| 項目(每百萬 tokens) | 限時價 | 人民幣價 |
|---|---|---|
| 輸入(未緩存) | $0.30 | ¥2 |
| 緩存輸入 | $0.006 | ¥0.04 |
| 輸出 | $1.20 | ¥8 |
| 企業批量折扣(已認證公司,月消費 $75+ / $300+ / $1,200+ / $6,000+) | 九折 / 八折 / 七折 / 六折 | — |
| Token Pack(30 天額度,閃購 10:00 / 16:00 / 21:00 / 23:00 北京時間) | 規格與價格登錄後可見 | — |
緩存價是真正的殺手鐧
緩存輸入 $0.006 僅爲未緩存價的 2%(1/50),對反覆讀取同一倉庫、同一長文檔的 Agent 任務意義重大。官方算例:60 萬未緩存輸入 + 40 萬緩存輸入 + 50 萬輸出 = $0.7824。計費規則也友好:僅 HTTP 200 請求計費,預付餘額永不過期,無上下文長度附加費,無圖像/視頻附加費。
同價對照
DeepSeek V4.1 Flash 的高峯價 $0.30/$1.20 與 LongCat 限時價完全相同,但 DeepSeek 非高峯半價($0.15/$0.60),月度賬單上 DeepSeek 更便宜;同檔旗艦則貴數倍:Kimi K3.1 Pro $2/$10、Qwen3.8 Max $2/$6(均爲官方 API 價,11 月 13 日覈查)。
官方頁面:美團官方技術博客 · Hugging Face 權重倉庫 · LongCat 官網
06首批實測與測評
以下全部是 11 月 1–13 日的首批解讀與實測:樣本小、方法不一,請按「個案」看待。注意一個時間陷阱——11 月 4 日之前寫的東西都說權重 "coming soon",現在已經過時。每條都給出結論徽章;點「閱讀本站全文」進入本站的深度改寫文章頁,文末附原始出處。
中文來源
美團技術團隊博客:長程 Agent 是怎麼訓出來的
結論:官方訓練方法的唯一詳細披露來源:美團技術團隊博客,2026-11-02(訓練方法:長程 RL、MOPD 蒸餾、W4A4 量化)
長程強化學習用 F2P/P2P 框架與防獎勵作弊設計;多教師蒸餾(MOPD)把多位教師的能力壓進一個模型;W4A4 量化推理在預填充與解碼上各快約 43%,首 token 延遲降約 16%。訓練在國產加速器上完成,單卡顯存不足 80GB。
新京報:萬億參數、國產加速器訓練
結論:中文媒體對訓練基礎設施的報道來源:新京報(經 tokenheart 英譯),2026-11-02
報道聚焦 1.6T 參數規模與全程國產加速器訓練兩點;未涉及基準口徑與價格細節,信息量以官方博客爲準。
英文來源
eesel 深度解讀:便宜的視覺編碼 Agent,但同價 DeepSeek 更強
結論:值得一試,但別指望它贏過 DeepSeek來源:eesel,2026-11-03(逐頁深讀官方文檔:視覺限制、輸出上限、社區反饋、數據政策)
視覺輸入是 2.5 的真正增量,但輸出上限 128K 與 262,144 兩個口徑打架,eesel 建議按 128K 規劃;Reddit 反饋長任務循環、約 200K 上下文後失態;FAQ 未說明 prompt 保留與訓練用途,客服場景是紅燈。注意:eesel 寫於 11 月 3 日,其「權重未發佈」結論已隨 11 月 4 日 MIT 發佈而過時。
閱讀本站全文 → (本站原創整理)
apiyi 基準指南:25 項基準逐項解讀
結論:最全的官方表解讀,附價格算例與接入步驟來源:apiyi,2026-11-03(官方基準表、價格算例、接入指南)
逐項解讀官方基準表並給出官方算例 $0.7824 的完整拆解;另有長程 Agent 訓練方法的專文解讀。同樣寫於權重發布前,「權重 coming soon」的表述已過時。
閱讀本站全文 → (本站原創整理)
toolpilotpro 三方橫評:月度賬單算得很細,結論已過時一半
結論:賬單測算可信,開放性結論請以本站修正版爲準來源:toolpilotpro,2026-11-04 更新(LongCat vs Kimi vs DeepSeek)
月度工作量測算(40M 輸入一半緩存 + 8M 輸出):DeepSeek 非高峯 $7.86、高峯 $15.72、LongCat $15.72、Kimi $124。但 11 月 4 日更新版仍稱 LongCat API-only、權重 coming soon——11 月 4 日 HF 已發佈 MIT 權重,本站橫評已按此修正。
閱讀本站全文 → (本站原創整理)
orcarouter 預覽分析:預覽期的核查
結論:預覽期數據,GA 後僅供參考來源:orcarouter,2026-10-13 數據(預覽版覈查)
對預覽版的規格與定價做了早期覈查;GA 後視覺能力、視頻輸入與權重狀態均已變化,結論以 GA 後來源爲準。
TokenDyno 實時測速:約 51.8 tok/s
結論:速度中游,樣本很小來源:TokenDyno,2026-11-13(OpenCode Go 實測,n=4)
LongCat 2.5(Free)在 OpenCode Go 上約 51.8 tok/s,首 token 約 2.8 秒。樣本只有 4 次,網關與負載都會影響結果,僅供參考。
社區反饋:循環、對照集與單人自測
結論:個案爲主,但指向同一個缺口——沒有獨立復現來源:Reddit、Hacker News,2026-11-02 之後
Reddit 預覽反饋:長任務上循環、窄角色小任務表現好、不適合做規劃與創意寫作;HN 批評價格與對照集選擇(頭圖不含 Opus 5.5、GPT-6.1 Sol、Kimi K3.1 Pro);單人自測預覽版 Terminal-Bench 2.1 約 48.7%,與官方 88.4 的差距主要來自 harness 與版本不同,不能直接比。
06B文章目錄:本站深度解讀
以下 6 篇均爲本站原創改寫與再整理的深度文章——重新組織結構、補充結論與選型建議,事實與數據與原始測評覈對一致。點擊任意一篇在本站內閱讀,文末附原始出處。
06C基準測試:官方 31 項 + 獨立測量(暫無)
官方給了 31 項,分代碼 Agent、通用 Agent、視覺三類,數據很全;但全部是廠商自測,對手分數一半是公開報告、一半是美團自跑。讀分數前先看條件,再看獨立測量怎麼說——目前是「沒有」。
| 測試(官方表,廠商自測) | 2.5 | 2.0 | 同價對照:DeepSeek V4.1 Flash |
|---|---|---|---|
| Terminal-Bench 2.1 | 88.4 | 70.8 | 90.6 |
| Terminal-Bench 4.0 | 38.5 | 3.0 | 31.2 |
| DeepSWE v1.1 | 64.6 | 9.7 | 74.2 |
| BrowseComp | 91.9 | — | 91.5 |
| 3DCodeBench Text→3D | 55.4 | — | — |
| PaperBench | 82.1 | — | — |
| VideoMME | 85.2 | — | — |
| HLE(with tools) | 63.1 | — | — |
| JobBench | 65.4 | — | — |
| MCP Atlas | 83.1 | — | 84.4 |
| AutomationBench | 51.8 | 15.8 | 54.8 |
| NL2Repo | 60.5 | — | 65.4 |
| ProgramBench | 25.5 | 2.5 | 20.3 |
| Agents' Last Exam v1.1 | 38.5 | — | — |
| ResearchRubrics | 81.0 | — | — |
獨立測量與第三方數據
| 測量 | 來源 | 2.5 成績 | 對照 |
|---|---|---|---|
| AA 智能指數 | Artificial Analysis | 未收錄(截至 11 月 13 日) | AA 榜單上只有 2.0 與 Flash Lite |
| ArtificialWatch 報告 | ArtificialWatch,11 月 13 日 08:59 UTC | "not rated yet" | — |
| TokenDyno 實時測速 | TokenDyno(OpenCode Go,n=4) | 約 51.8 tok/s,TTFT 約 2.8 秒 | — |
| OpenVibeEval 排名 | OpenVibeEval 排行榜 | 2.5 Preview 第 40 名 | 預覽版,非 GA 版 |
| 社區自測 TB 2.1 | 單人開發者,預覽版,不同 harness | 約 48.7% pass@1 | 官方自報 88.4——不可直接比 |
完整盤點見本站基準測試專文 →
07對比
vs LongCat 2.0(前代)
| 維度 | LongCat 2.5 | LongCat 2.0 |
|---|---|---|
| 發佈 | 2026-11-02 GA | 2026-06-30 GA |
| 參數 | 1.6T 總 / 約 48B 激活 | 同款底座(2.5 與 2.0 共享底座) |
| 輸入 | 文本、圖像、視頻 | 純文本 |
| 權重 | MIT,已發佈(11 月 4 日) | MIT,已發佈 |
| Terminal-Bench 2.1 | 88.4 | 70.8(AA 實測 50.2) |
| Terminal-Bench 4.0 | 38.5 | 3.0 |
| DeepSWE v1.1 | 64.6 | 9.7 |
| AutomationBench | 51.8 | 15.8 |
| ProgramBench | 25.5 | 2.5 |
| 價格 | $0.30 / $1.20(限時價) | $0.75 / $2.95(舊目錄價) |
2.5 的躍升主要來自視覺與 Agent 訓練,而非參數規模——底座相同,Terminal-Bench 4.0 從 3.0 漲到 38.5、DeepSWE 從 9.7 漲到 64.6。價格反而降了:限時價只有 2.0 目錄價的約四成。
vs 同價與同檔對手(2026-11-13 口徑)
| 模型 | 發佈 | AA 指數 | API 價格 $/百萬(入/出) | 權重 |
|---|---|---|---|---|
| 美團 LongCat 2.5 | 11 月 2 日 | 未收錄 | 0.30 / 1.20(限時價) | MIT,已發佈 |
| DeepSeek V4.1 Flash | 9 月 10 日 | 32.6 | 0.30 / 1.20(高峯);0.15 / 0.60(非高峯) | MIT,已發佈 |
| Kimi K3.1 Pro | 10 月 23 日 | 46 | 2.00 / 10.00 | 已發佈(11 月 4 日,自定義許可) |
| 騰訊 Hy4 | 11 月 4 日 | 35 | 0.83 / 2.50(5 折:0.42 / 1.25) | 待發布 |
| Inkling 2 Small | 11 月 5 日 | 31 | 0.30 / 1.00 | Apache 2.0,已發佈 |
08還缺什麼(截至 11 月 13 日)
- Artificial Analysis 獨立評分(截至 11 月 13 日未收錄;無任何第三方跑分復現)
- 數據政策:prompt 是否保留、是否用於訓練,FAQ 未說明
- 限時折扣的截止日期與折扣後的目錄價
- Token Pack 的規格與價格(登錄後可見,未公開)
- 速率限制(RPM/TPM,未公佈)
- vLLM 支持與自託管的 VRAM 指引(README 只給 NPU + SGLang-FluentLLM)
- 知識截止日期(未見官方公佈)
- 2.0 / 2.5-Preview 的帶日期下線公告(已從模型列表消失,無正式公告)
- 1M 上下文的獨立長上下文評測(config 基數 512K + YaRN 的實際表現無驗證)
- 最大輸出 128K vs 262,144 的文檔口徑統一
09謠言覈查
LongCat 2.5 的混淆主要來自時間差——11 月 1–3 日的報道在 11 月 4 日權重發布後大半過時,以及幾個被傳錯的數字,逐條澄清如下。
不成立 「440B 激活參數」
發佈日部分社區帖稱 440B 激活——錯。官方爲約 48B 激活(config.json:768 路由專家,top-12 路由),440B 沒有任何官方來源。
已澄清 「權重 coming soon,只能走 API」
11 月 1–3 日的報道(包括 11 月 4 日更新的 toolpilotpro 橫評)都這麼說,但 11 月 4 日兩個倉庫已上架 Hugging Face:全量 3,317.3 GB 與 W4A4 1,244.3 GB,MIT 協議。本站經 HF API 覈實建倉時間與協議。
不成立 「$0.30/$1.20 就是永久價」
官方定價頁明確標註限時折扣(limited-time discount),無截止日期、無目錄價,並稱「價格可能變動」。2.0 的舊目錄價是 $0.75/$2.95——2.5 若移到該價,輸出約漲 2.5 倍(推測,美團未表態)。
部分成立 「Terminal-Bench 2.1 只有 48.7%」
48.7% 是單人開發者對預覽版的自測(不同 harness),不是 2.5 GA 的分數;官方自報 88.4 同樣是廠商口徑。兩個數字測的不是同一個東西,在獨立復現出現之前,88.4 與 48.7 都不能當作 GA 版的定論。
部分成立 「1M 上下文」
API 口徑確爲 1,048,576(輸入 + 輸出合計),但 config 基數是 524,288,經 YaRN 擴展到 1M。2.0 曾有「宣傳 1M、配置上限 256K」的前科(eesel),2.5 的 1M 實際表現尚無獨立長上下文評測驗證。
已澄清 「到底是 11 月 1 日還是 11 月 2 日發佈?」
技術博客 11 月 1 日官宣,API 平臺 11 月 2 日 GA 上線。本站以 11 月 2 日爲發佈日:那是它實際可用的第一天;預覽版則是 9 月 25 日。
10FAQ
LongCat 2.5 什麼時候發佈的?
2026 年 11 月 1 日技術博客官宣,11 月 2 日在 LongCat API Platform GA 上線;預覽版 9 月 25 日發佈。本站以 11 月 2 日爲發佈日。時間線見本頁第 02 節。
LongCat 2.5 的權重在哪裏下載?
Hugging Face 組織 meituan-longcat 下的兩個倉庫:LongCat-2.5(全量 3,317.3 GB,210 個分片)與 LongCat-2.5-W4A4(1,244.3 GB,208 個分片),均爲 MIT 協議,2026 年 11 月 4 日上架;ModelScope 亦有鏡像。詳見本站權重狀態專文。
LongCat 2.5 是開源的嗎?
是。權重 2026 年 11 月 4 日以 MIT 協議發佈,可商用、可修改、可再分發;前代 2.0 同爲 MIT。注意 11 月初的不少報道仍稱權重 "coming soon",已經過時。
LongCat 2.5 價格是多少?
限時價:輸入 $0.30 / 緩存輸入 $0.006 / 輸出 $1.20(每百萬 tokens;人民幣 ¥2 / ¥0.04 / ¥8)。折扣無截止日期、無目錄價,官方稱「價格可能變動」。僅 HTTP 200 請求計費,預付餘額永不過期。詳見本站價格指南。
LongCat 2.5 怎麼用?有哪些渠道?
官方聊天應用 longcat.ai/chat、LongCat API Platform(模型 ID LongCat-2.5)、Vercel AI Gateway、AnyRouter;免費路線有 OpenCode Zen(longcat-2.5-free)與 Nous Portal 免費端點。注意:不在 OpenRouter。本地部署可用已發佈的 MIT 權重,但 README 只指引 NPU + SGLang-FluentLLM。
LongCat 2.5 的 AA 指數是多少?
截至 11 月 13 日,Artificial Analysis 尚未收錄 LongCat 2.5,沒有獨立評分;AA 榜單上只有 2.0 與 Flash Lite。ArtificialWatch 11 月 13 日的報告同樣寫 "not rated yet"。本站會持續跟蹤。
Terminal-Bench 2.1 的 88.4 分可信嗎?
88.4 是美團官方自報(Claude Code v2.1.280 harness,最大序列 512K),在獨立復現前應按「廠商口徑」看待。警示:AA 曾測得 2.0 的 TB 2.1 爲 50.2%,比美團表內 70.8 低 20 分;社區單人自測預覽版 2.5 約 48.7%(不同 harness,僅作參考)。
LongCat 2.5 和 2.0 有什麼區別?
兩者共享底座,2.5 新增原生視覺(圖像 + 視頻輸入)與長程 Agent 訓練:Terminal-Bench 4.0 從 3.0 升至 38.5,DeepSWE 從 9.7 升至 64.6,AutomationBench 從 15.8 升至 51.8。價格反而降了:2.5 限時價 $0.30/$1.20,約爲 2.0 舊目錄價 $0.75/$2.95 的四成。
LongCat 2.5 和 DeepSeek V4.1 Flash 比怎麼樣?
兩者限時價/高峯價完全相同($0.30/$1.20),但 DeepSeek 非高峯半價,月度賬單更便宜;基準上 DeepSeek 領先多數編碼行(DeepSWE 74.2 對 64.6、TB 2.1 90.6 對 88.4),LongCat 領先 TB 4.0(38.5 對 31.2)、BrowseComp(91.9 對 91.5)與 ProgramBench(25.5 對 20.3)。兩者權重均爲 MIT。詳見本站三方橫評。
LongCat 2.5 支持視覺和視頻嗎?
支持。輸入可含圖像(PNG/JPG/JPEG/WebP/GIF,≤10MB,≤50/請求)與視頻(≤100MB,<3600 秒,≤10/請求,僅公開 URL);不支持 SVG/HEIC,長寬比 >200:1 報錯。視覺爲原生多層離散 token,無獨立視覺編碼器;輸出仍爲純文本。視頻理解隨 11 月 2 日 GA 加入,預覽版沒有。
最大輸出到底是 128K 還是 262K?
官方文檔口徑不一:Quick Start、FAQ 與美團 Claude Code 配置稱 131,072(128K),Model Parameters 頁稱 max_tokens 可至 262,144。本站與 eesel 的建議一致:按 128K 規劃,262K 未經證實。
LongCat 2.5 的上下文窗口多大?
API 口徑 1,048,576 tokens(輸入 + 輸出合計)。權重倉庫 config 的基數是 524,288,經 YaRN rope scaling 擴展到 1M;實際長上下文表現尚無獨立評測驗證。
11來源
本頁事實均來自以下公開來源(覈查於 2026 年 11 月 13 日)。
官方
- 美團 LongCat 團隊 — Introducing LongCat-2.5(官方技術博客,含 31 項基準表與架構細節) 11 月 1 日
- 美團技術團隊 — 美團 LongCat 2.5:長程 Agent 訓練方法(長程 RL、MOPD 蒸餾、W4A4 量化) 11 月 2 日
- Hugging Face — meituan-longcat/LongCat-2.5(MIT 權重,全量 3,317.3 GB,含 config.json 與評測表) 11 月 4 日
- Hugging Face — meituan-longcat/LongCat-2.5-W4A4(W4A4 量化權重,1,244.3 GB) 11 月 4 日
- LongCat 官網 — longcat.ai(聊天應用與 API 平臺入口)
英文報道與分析
- eesel — LongCat 2.5: Meituan's New Multimodal Coding Model, Explained(逐頁深讀官方文檔) 11 月 3 日
- apiyi — What Can LongCat 2.5 Actually Do?(官方基準與價格指南) 11 月 3 日
- apiyi — LongCat 2.5 Long-Horizon Agent Training, Explained(訓練方法解讀)
- ToolPilotPro — LongCat-2.5 Guide(價格與折扣說明)
- ToolPilotPro — LongCat-2.5 vs Kimi K3.1 Pro vs DeepSeek(三方橫評;11 月 4 日更新版仍稱 API-only,已過時) 11 月 4 日更新
- OrcaRouter — LongCat 2.5 預覽分析(10 月 13 日數據)
- ArtificialWatch — LongCat 2.5 報告("not rated yet") 11 月 13 日
- TokenDyno — 實時測速(OpenCode Go 約 51.8 tok/s,n=4)
- OpenVibeEval — 排行榜(2.5 Preview 第 40 名)
- TokenHeart — 新京報報道英譯:萬億參數、國產加速器訓練