美团 LongCat 2.5 专题
美团 LongCat 团队 2026 年 11 月 2 日 GA 的最新一代模型:1.6T 总参数 MoE,约 48B 激活,原生多模态(文本 + 图像 + 视频输入),为长程 Agent 任务训练,1M 上下文。限时价 $0.30/$1.20 与 DeepSeek V4.1 Flash 完全相同,官方自报 Terminal-Bench 2.1 88.4 分;但截至 11 月 13 日没有任何独立机构评分,折扣既无截止日期也无目录价,而权重已在 11 月 4 日悄然 MIT 开源——11 月初的大多数报道都还没跟上这一变化。本页汇总官方规格、上手路线、价格与中英文首批解读,并明确标注哪些说法尚未证实。
01关键事实
先把能确认的说清楚:这是个 1.6T 参数的原生多模态 Agent 模型,定价与 DeepSeek V4.1 Flash 针锋相对,权重已经 MIT 开源——但所有亮眼分数都来自厂商自测,独立验证一张都没有。
- 发布
- 2026-11-02 GA(LongCat API Platform 上线;技术博客 11 月 1 日官宣,预览版 9 月 25 日)。本站以 11 月 2 日为发布日:那是它实际可用的第一天。
- 开发方
- 美团 LongCat 团队,中国美团旗下大模型团队
- 架构
- 稀疏 MoE;1.6T 总参数,每 token 激活约 48B(权重仓库 config.json:38 层,768 路由专家,top-12 路由,MLA 注意力,词表 163,840)
- 上下文
- 1M tokens(API 口径 1,048,576,输入 + 输出合计);config 基数 524,288,经 YaRN 扩展;最大输出 128K(文档口径不一,见第 09 节)
- 输入 / 输出
- 输入:文本、图像、视频;输出:文本。思考模式经 reasoning_content 字段返回;温度固定(思考开 1.0、关 0.7,传入其它值会被静默覆盖)
- 新能力
- 原生多模态视觉(多层离散 token,无独立视觉编码器);视频理解随 GA 加入;长程 Agent 训练(F2P/P2P 强化学习、MOPD 多教师蒸馏)
- 价格
- 限时折扣:输入 $0.30 / 缓存输入 $0.006 / 输出 $1.20(每百万 tokens;人民币 ¥2 / ¥0.04 / ¥8);无截止日期、无目录价,官方称「价格可能变动」
- 基准分
- 官方自报 31 项:Terminal-Bench 2.1 88.4、DeepSWE 64.6、BrowseComp 91.9(表内第一)、3DCodeBench 55.4(表内第一);独立评分:暂无(Artificial Analysis 尚未收录,截至 11 月 13 日)
- 权重
- 已发布(2026-11-04,MIT 协议;全量 3,317.3 GB,W4A4 量化版 1,244.3 GB;Hugging Face,另有 ModelScope 镜像)
- 可用渠道
- longcat.ai/chat、LongCat API Platform(模型 ID
LongCat-2.5)、Vercel AI Gateway、AnyRouter、OpenCode(Zen 免费版)、Nous Portal;不在 OpenRouter(11 月 13 日核查) - 前代
- LongCat 2.0(2026-06-30 GA,MIT 权重);2.5 与 2.0 同款底座 + 视觉与 Agent 训练
- 知识截止
- 未见官方公布
02时间线
从 2.0 到 2.5 只隔了四个月:预览、官宣、GA、权重开源在七周内走完——权重上架甚至没等一篇正式公告。
- 2026-04-20
LongCat 2.0 预览版发布:纯文本 Agent 模型,1M 上下文。
- 2026-06-30
2.0 GA 并 MIT 开源权重(Hugging Face 建仓 7 月 5 日);当时的目录价为 $0.75 / $0.015 / $2.95。
- 2026-09-25
LongCat 2.5 预览版发布:纯文本,视觉能力尚未开放;社区自测预览版 Terminal-Bench 2.1 约 48.7%(单人、不同 harness,仅作参考)。
- 2026-11-01
技术博客官宣 LongCat 2.5:公布 1.6T 参数、原生多模态架构与 31 项官方基准;权重标注 "coming soon"。
- 2026-11-02
GA 上线 LongCat API Platform:视频理解随 GA 加入;限时价 $0.30/$1.20 同日生效。同日美团技术团队博客公布训练方法(国产加速器、W4A4、长程 RL)。
- 2026-11-04
权重悄然上架 Hugging Face:全量 + W4A4 两个仓库,MIT 协议,无正式公告;Nous Portal 同日上线免费端点。
- 2026-11-09
OpenCode Zen 推出免费版
longcat-2.5-free;付费版随 OpenCode Go 提供。 - 2026-11-13
Artificial Analysis 仍未收录(ArtificialWatch 当日报告 "not rated yet");本站专题上线。
03官方规格
以下为官方已公布口径(技术博客、API 平台文档与 Hugging Face 权重仓库 config.json,2026 年 11 月 13 日核查)。注意:最大输出与上下文各有两个口径,见正文与第 09 节。
- 状态
- 已发布(2026-11-02 GA);权重已发布(2026-11-04)
- 模型 ID
- LongCat-2.5
- 架构
- 稀疏 MoE;1.6T 总参数,约 48B 激活;38 层,768 路由专家,top-12 路由,MLA 注意力,词表 163,840
- 上下文窗口
- 1M tokens(API 口径 1,048,576,输入 + 输出合计;config 基数 524,288,经 YaRN rope scaling 扩展)
- 最大输出
- 128K tokens(Quick Start、FAQ 与美团 Claude Code 配置口径;Model Parameters 页称 max_tokens 可至 262,144——文档口径不一,按 128K 规划)
- 输入
- 文本、图像(PNG/JPG/JPEG/WebP/GIF,≤10MB,≤50/请求)、视频(≤100MB,<3600 秒,≤10/请求,仅公开 URL;不支持 SVG/HEIC,长宽比 >200:1 报错)
- 输出
- 文本
- 思考模式
- 经 reasoning_content 字段返回;温度固定(思考开 1.0、关 0.7)
- API 协议
- OpenAI Chat Completions、OpenAI Responses(供 Codex,effort none 至 xhigh)、Anthropic Messages;端点 api.longcat.chat
- 训练
- 国产加速器(<80GB 显存)训练;W4A4 量化推理;长程 RL(F2P/P2P,防奖励作弊);MOPD 多教师蒸馏
- 基准分
- 官方自报 31 项(见第 06C 节);独立评分暂无
- 权重
- MIT;全量 3,317.3 GB(210 个分片)、W4A4 1,244.3 GB(208 个分片)
- 许可
- MIT
- API 价格
- $0.30 输入 / $0.006 缓存 / $1.20 输出(限时折扣,无截止日期)
04怎么试用:6 条路线
权重已开源,但 3.3TB 的体积与 NPU 导向的部署指引意味着多数人还是走托管 API。最快的是 OpenCode 免费版与 Nous Portal 的免费端点。
1LongCat API Platform(官方主路线)
美团官方 API 平台,模型 ID LongCat-2.5。OpenAI 与 Anthropic 双协议兼容,端点 api.longcat.chat;预付余额永不过期,仅 HTTP 200 请求计费。邮箱注册,中国大陆外无需身份核验;USD 站支持信用卡、借记卡与 Google Pay。官方提供 13 份工具接入指南(Claude Code、Codex、OpenCode、Cline、Kilo Code、Hermes、OpenClaw 等)。
2longcat.ai/chat(官方聊天应用)
官方聊天入口,登录后直接使用;回复默认中文。有社区反馈称登录会跳转到另一域名,体验上略有割裂。
3网关:Vercel AI Gateway、AnyRouter
2.5 已接入 Vercel AI Gateway 与 AnyRouter,适合已有网关账单的开发者统一调用。注意:不在 OpenRouter(11 月 13 日经 OpenRouter API 核查,仅有 meituan/longcat-2.0);APIYI 已宣布计划接入,截至 11 月 3 日尚未上线。
4OpenCode Zen 免费版
11 月 9 日起,OpenCode Zen 提供免费版 longcat-2.5-free;付费版随 OpenCode Go 提供。适合编码 Agent 场景零成本试用。
5Nous Portal 免费端点
11 月 4 日上线免费端点,另一条零成本试用路线。
6本地部署(权重已开源)
Hugging Face 两个仓库均可下载:全量 3,317.3 GB(210 分片)与 W4A4 1,244.3 GB(208 分片),MIT 协议,另有 ModelScope 镜像。README 只指引 NPU + 美团 SGLang-FluentLLM 分支部署;vLLM 支持未见官方说明(未证实),官方也未公布自托管的 VRAM 需求——不要按 3.3TB 体积自行推算显卡数。
05价格解析
限时价与 DeepSeek V4.1 Flash 高峰价一分不差——这是有意为之的同价对位。但折扣没有截止日期、没有目录价,长期预算没法按这个价锁定。价格为 2026 年 11 月 13 日核查口径,结账页价格为准。
| 项目(每百万 tokens) | 限时价 | 人民币价 |
|---|---|---|
| 输入(未缓存) | $0.30 | ¥2 |
| 缓存输入 | $0.006 | ¥0.04 |
| 输出 | $1.20 | ¥8 |
| 企业批量折扣(已认证公司,月消费 $75+ / $300+ / $1,200+ / $6,000+) | 九折 / 八折 / 七折 / 六折 | — |
| Token Pack(30 天额度,闪购 10:00 / 16:00 / 21:00 / 23:00 北京时间) | 规格与价格登录后可见 | — |
缓存价是真正的杀手锏
缓存输入 $0.006 仅为未缓存价的 2%(1/50),对反复读取同一仓库、同一长文档的 Agent 任务意义重大。官方算例:60 万未缓存输入 + 40 万缓存输入 + 50 万输出 = $0.7824。计费规则也友好:仅 HTTP 200 请求计费,预付余额永不过期,无上下文长度附加费,无图像/视频附加费。
同价对照
DeepSeek V4.1 Flash 的高峰价 $0.30/$1.20 与 LongCat 限时价完全相同,但 DeepSeek 非高峰半价($0.15/$0.60),月度账单上 DeepSeek 更便宜;同档旗舰则贵数倍:Kimi K3.1 Pro $2/$10、Qwen3.8 Max $2/$6(均为官方 API 价,11 月 13 日核查)。
官方页面:美团官方技术博客 · Hugging Face 权重仓库 · LongCat 官网
06首批实测与测评
以下全部是 11 月 1–13 日的首批解读与实测:样本小、方法不一,请按「个案」看待。注意一个时间陷阱——11 月 4 日之前写的东西都说权重 "coming soon",现在已经过时。每条都给出结论徽章;点「阅读本站全文」进入本站的深度改写文章页,文末附原始出处。
中文来源
美团技术团队博客:长程 Agent 是怎么训出来的
结论:官方训练方法的唯一详细披露来源:美团技术团队博客,2026-11-02(训练方法:长程 RL、MOPD 蒸馏、W4A4 量化)
长程强化学习用 F2P/P2P 框架与防奖励作弊设计;多教师蒸馏(MOPD)把多位教师的能力压进一个模型;W4A4 量化推理在预填充与解码上各快约 43%,首 token 延迟降约 16%。训练在国产加速器上完成,单卡显存不足 80GB。
新京报:万亿参数、国产加速器训练
结论:中文媒体对训练基础设施的报道来源:新京报(经 tokenheart 英译),2026-11-02
报道聚焦 1.6T 参数规模与全程国产加速器训练两点;未涉及基准口径与价格细节,信息量以官方博客为准。
英文来源
eesel 深度解读:便宜的视觉编码 Agent,但同价 DeepSeek 更强
结论:值得一试,但别指望它赢过 DeepSeek来源:eesel,2026-11-03(逐页深读官方文档:视觉限制、输出上限、社区反馈、数据政策)
视觉输入是 2.5 的真正增量,但输出上限 128K 与 262,144 两个口径打架,eesel 建议按 128K 规划;Reddit 反馈长任务循环、约 200K 上下文后失态;FAQ 未说明 prompt 保留与训练用途,客服场景是红灯。注意:eesel 写于 11 月 3 日,其「权重未发布」结论已随 11 月 4 日 MIT 发布而过时。
阅读本站全文 → (本站原创整理)
apiyi 基准指南:25 项基准逐项解读
结论:最全的官方表解读,附价格算例与接入步骤来源:apiyi,2026-11-03(官方基准表、价格算例、接入指南)
逐项解读官方基准表并给出官方算例 $0.7824 的完整拆解;另有长程 Agent 训练方法的专文解读。同样写于权重发布前,「权重 coming soon」的表述已过时。
阅读本站全文 → (本站原创整理)
toolpilotpro 三方横评:月度账单算得很细,结论已过时一半
结论:账单测算可信,开放性结论请以本站修正版为准来源:toolpilotpro,2026-11-04 更新(LongCat vs Kimi vs DeepSeek)
月度工作量测算(40M 输入一半缓存 + 8M 输出):DeepSeek 非高峰 $7.86、高峰 $15.72、LongCat $15.72、Kimi $124。但 11 月 4 日更新版仍称 LongCat API-only、权重 coming soon——11 月 4 日 HF 已发布 MIT 权重,本站横评已按此修正。
阅读本站全文 → (本站原创整理)
orcarouter 预览分析:预览期的核查
结论:预览期数据,GA 后仅供参考来源:orcarouter,2026-10-13 数据(预览版核查)
对预览版的规格与定价做了早期核查;GA 后视觉能力、视频输入与权重状态均已变化,结论以 GA 后来源为准。
TokenDyno 实时测速:约 51.8 tok/s
结论:速度中游,样本很小来源:TokenDyno,2026-11-13(OpenCode Go 实测,n=4)
LongCat 2.5(Free)在 OpenCode Go 上约 51.8 tok/s,首 token 约 2.8 秒。样本只有 4 次,网关与负载都会影响结果,仅供参考。
社区反馈:循环、对照集与单人自测
结论:个案为主,但指向同一个缺口——没有独立复现来源:Reddit、Hacker News,2026-11-02 之后
Reddit 预览反馈:长任务上循环、窄角色小任务表现好、不适合做规划与创意写作;HN 批评价格与对照集选择(头图不含 Opus 5.5、GPT-6.1 Sol、Kimi K3.1 Pro);单人自测预览版 Terminal-Bench 2.1 约 48.7%,与官方 88.4 的差距主要来自 harness 与版本不同,不能直接比。
06B文章目录:本站深度解读
以下 6 篇均为本站原创改写与再整理的深度文章——重新组织结构、补充结论与选型建议,事实与数据与原始测评核对一致。点击任意一篇在本站内阅读,文末附原始出处。
06C基准测试:官方 31 项 + 独立测量(暂无)
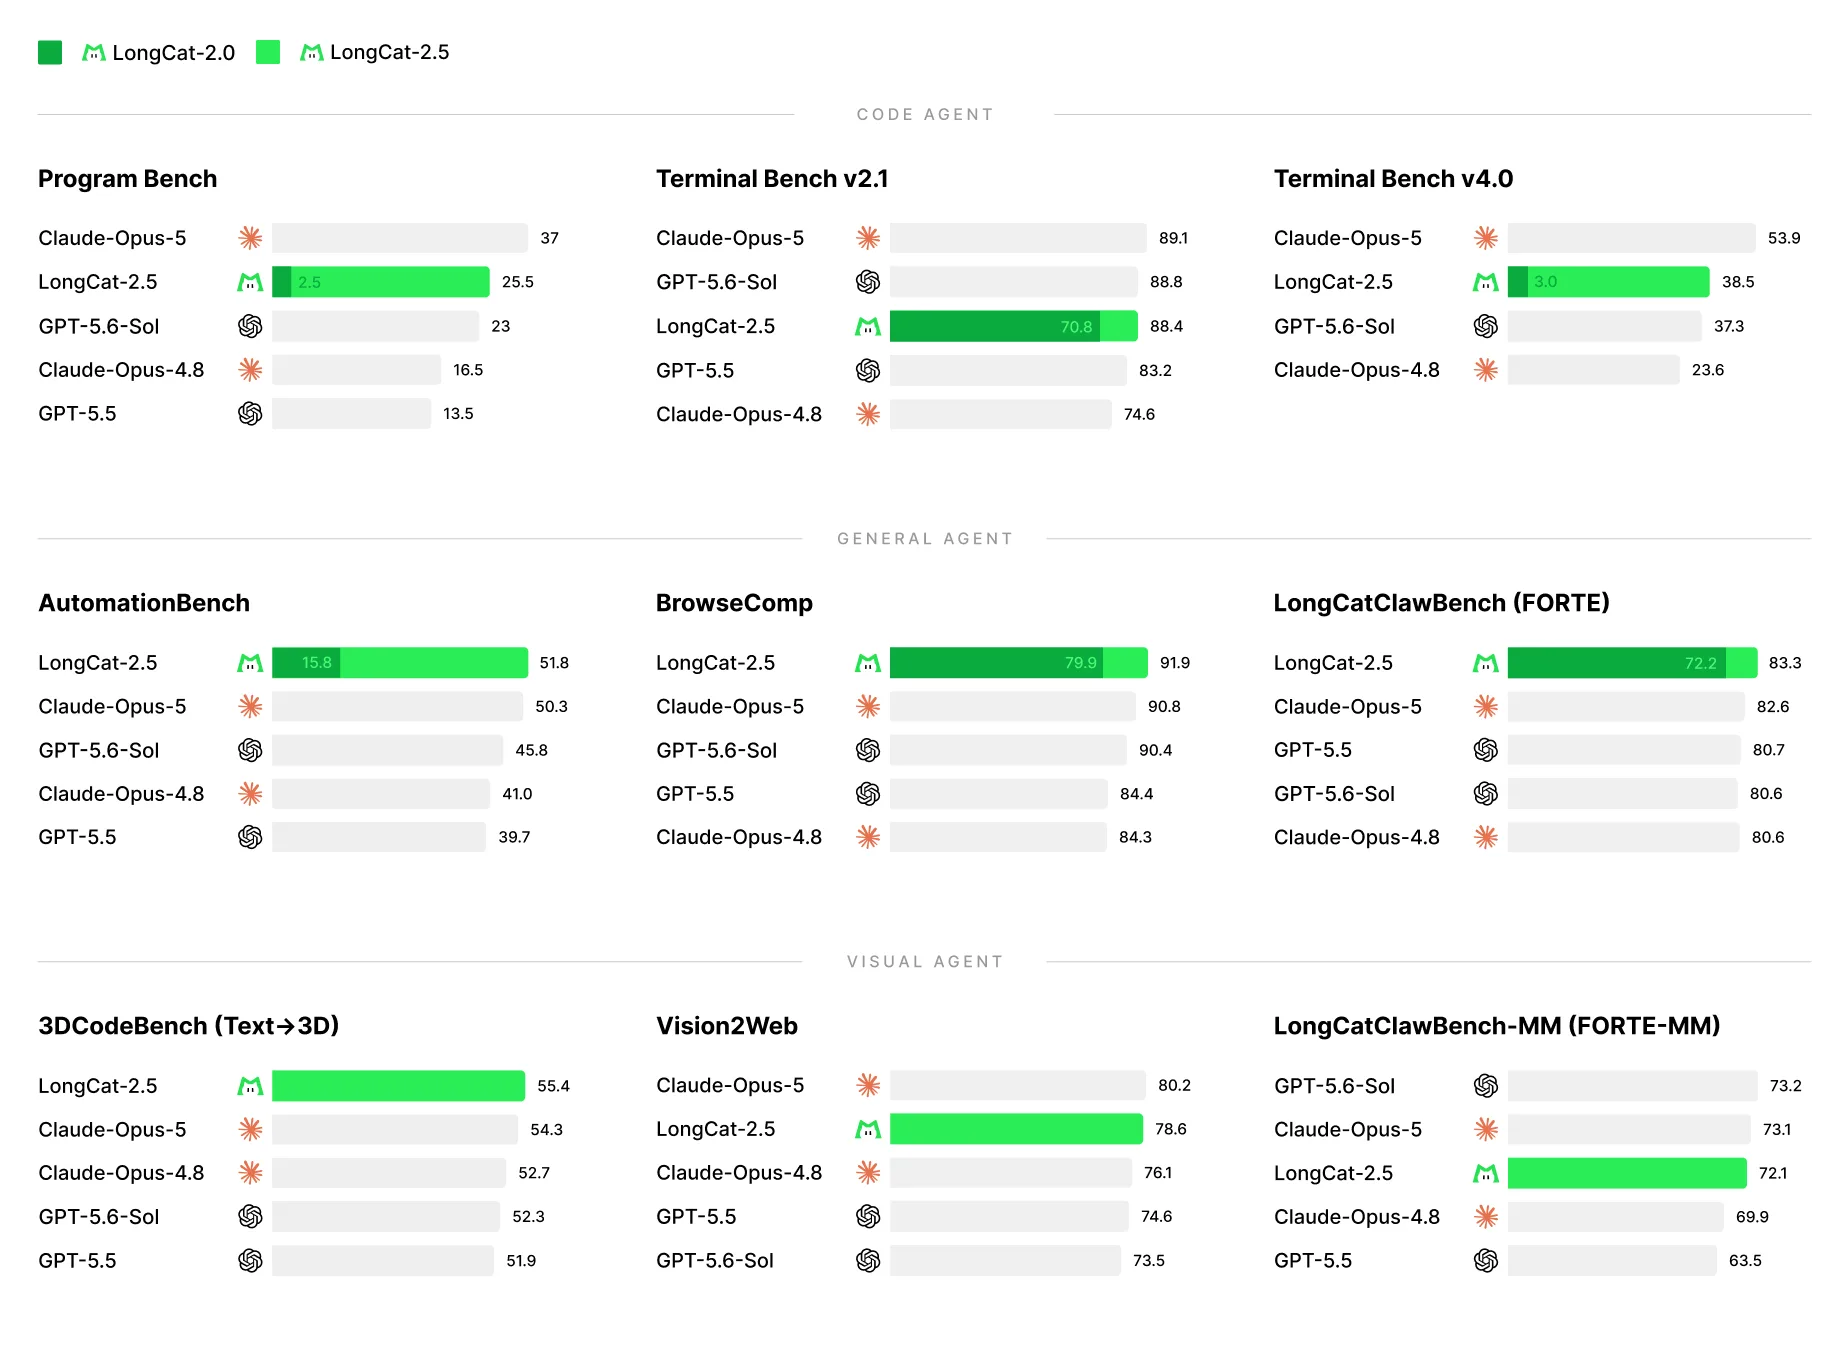
官方给了 31 项,分代码 Agent、通用 Agent、视觉三类,数据很全;但全部是厂商自测,对手分数一半是公开报告、一半是美团自跑。读分数前先看条件,再看独立测量怎么说——目前是「没有」。
| 测试(官方表,厂商自测) | 2.5 | 2.0 | 同价对照:DeepSeek V4.1 Flash |
|---|---|---|---|
| Terminal-Bench 2.1 | 88.4 | 70.8 | 90.6 |
| Terminal-Bench 4.0 | 38.5 | 3.0 | 31.2 |
| DeepSWE v1.1 | 64.6 | 9.7 | 74.2 |
| BrowseComp | 91.9 | — | 91.5 |
| 3DCodeBench Text→3D | 55.4 | — | — |
| PaperBench | 82.1 | — | — |
| VideoMME | 85.2 | — | — |
| HLE(with tools) | 63.1 | — | — |
| JobBench | 65.4 | — | — |
| MCP Atlas | 83.1 | — | 84.4 |
| AutomationBench | 51.8 | 15.8 | 54.8 |
| NL2Repo | 60.5 | — | 65.4 |
| ProgramBench | 25.5 | 2.5 | 20.3 |
| Agents' Last Exam v1.1 | 38.5 | — | — |
| ResearchRubrics | 81.0 | — | — |
独立测量与第三方数据
| 测量 | 来源 | 2.5 成绩 | 对照 |
|---|---|---|---|
| AA 智能指数 | Artificial Analysis | 未收录(截至 11 月 13 日) | AA 榜单上只有 2.0 与 Flash Lite |
| ArtificialWatch 报告 | ArtificialWatch,11 月 13 日 08:59 UTC | "not rated yet" | — |
| TokenDyno 实时测速 | TokenDyno(OpenCode Go,n=4) | 约 51.8 tok/s,TTFT 约 2.8 秒 | — |
| OpenVibeEval 排名 | OpenVibeEval 排行榜 | 2.5 Preview 第 40 名 | 预览版,非 GA 版 |
| 社区自测 TB 2.1 | 单人开发者,预览版,不同 harness | 约 48.7% pass@1 | 官方自报 88.4——不可直接比 |
完整盘点见本站基准测试专文 →
07对比
vs LongCat 2.0(前代)
| 维度 | LongCat 2.5 | LongCat 2.0 |
|---|---|---|
| 发布 | 2026-11-02 GA | 2026-06-30 GA |
| 参数 | 1.6T 总 / 约 48B 激活 | 同款底座(2.5 与 2.0 共享底座) |
| 输入 | 文本、图像、视频 | 纯文本 |
| 权重 | MIT,已发布(11 月 4 日) | MIT,已发布 |
| Terminal-Bench 2.1 | 88.4 | 70.8(AA 实测 50.2) |
| Terminal-Bench 4.0 | 38.5 | 3.0 |
| DeepSWE v1.1 | 64.6 | 9.7 |
| AutomationBench | 51.8 | 15.8 |
| ProgramBench | 25.5 | 2.5 |
| 价格 | $0.30 / $1.20(限时价) | $0.75 / $2.95(旧目录价) |
2.5 的跃升主要来自视觉与 Agent 训练,而非参数规模——底座相同,Terminal-Bench 4.0 从 3.0 涨到 38.5、DeepSWE 从 9.7 涨到 64.6。价格反而降了:限时价只有 2.0 目录价的约四成。
vs 同价与同档对手(2026-11-13 口径)
| 模型 | 发布 | AA 指数 | API 价格 $/百万(入/出) | 权重 |
|---|---|---|---|---|
| 美团 LongCat 2.5 | 11 月 2 日 | 未收录 | 0.30 / 1.20(限时价) | MIT,已发布 |
| DeepSeek V4.1 Flash | 9 月 10 日 | 32.6 | 0.30 / 1.20(高峰);0.15 / 0.60(非高峰) | MIT,已发布 |
| Kimi K3.1 Pro | 10 月 23 日 | 46 | 2.00 / 10.00 | 已发布(11 月 4 日,自定义许可) |
| 腾讯 Hy4 | 11 月 4 日 | 35 | 0.83 / 2.50(5 折:0.42 / 1.25) | 待发布 |
| Inkling 2 Small | 11 月 5 日 | 31 | 0.30 / 1.00 | Apache 2.0,已发布 |
08还缺什么(截至 11 月 13 日)
- Artificial Analysis 独立评分(截至 11 月 13 日未收录;无任何第三方跑分复现)
- 数据政策:prompt 是否保留、是否用于训练,FAQ 未说明
- 限时折扣的截止日期与折扣后的目录价
- Token Pack 的规格与价格(登录后可见,未公开)
- 速率限制(RPM/TPM,未公布)
- vLLM 支持与自托管的 VRAM 指引(README 只给 NPU + SGLang-FluentLLM)
- 知识截止日期(未见官方公布)
- 2.0 / 2.5-Preview 的带日期下线公告(已从模型列表消失,无正式公告)
- 1M 上下文的独立长上下文评测(config 基数 512K + YaRN 的实际表现无验证)
- 最大输出 128K vs 262,144 的文档口径统一
09谣言核查
LongCat 2.5 的混淆主要来自时间差——11 月 1–3 日的报道在 11 月 4 日权重发布后大半过时,以及几个被传错的数字,逐条澄清如下。
不成立 「440B 激活参数」
发布日部分社区帖称 440B 激活——错。官方为约 48B 激活(config.json:768 路由专家,top-12 路由),440B 没有任何官方来源。
已澄清 「权重 coming soon,只能走 API」
11 月 1–3 日的报道(包括 11 月 4 日更新的 toolpilotpro 横评)都这么说,但 11 月 4 日两个仓库已上架 Hugging Face:全量 3,317.3 GB 与 W4A4 1,244.3 GB,MIT 协议。本站经 HF API 核实建仓时间与协议。
不成立 「$0.30/$1.20 就是永久价」
官方定价页明确标注限时折扣(limited-time discount),无截止日期、无目录价,并称「价格可能变动」。2.0 的旧目录价是 $0.75/$2.95——2.5 若移到该价,输出约涨 2.5 倍(推测,美团未表态)。
部分成立 「Terminal-Bench 2.1 只有 48.7%」
48.7% 是单人开发者对预览版的自测(不同 harness),不是 2.5 GA 的分数;官方自报 88.4 同样是厂商口径。两个数字测的不是同一个东西,在独立复现出现之前,88.4 与 48.7 都不能当作 GA 版的定论。
部分成立 「1M 上下文」
API 口径确为 1,048,576(输入 + 输出合计),但 config 基数是 524,288,经 YaRN 扩展到 1M。2.0 曾有「宣传 1M、配置上限 256K」的前科(eesel),2.5 的 1M 实际表现尚无独立长上下文评测验证。
已澄清 「到底是 11 月 1 日还是 11 月 2 日发布?」
技术博客 11 月 1 日官宣,API 平台 11 月 2 日 GA 上线。本站以 11 月 2 日为发布日:那是它实际可用的第一天;预览版则是 9 月 25 日。
10FAQ
LongCat 2.5 什么时候发布的?
2026 年 11 月 1 日技术博客官宣,11 月 2 日在 LongCat API Platform GA 上线;预览版 9 月 25 日发布。本站以 11 月 2 日为发布日。时间线见本页第 02 节。
LongCat 2.5 的权重在哪里下载?
Hugging Face 组织 meituan-longcat 下的两个仓库:LongCat-2.5(全量 3,317.3 GB,210 个分片)与 LongCat-2.5-W4A4(1,244.3 GB,208 个分片),均为 MIT 协议,2026 年 11 月 4 日上架;ModelScope 亦有镜像。详见本站权重状态专文。
LongCat 2.5 是开源的吗?
是。权重 2026 年 11 月 4 日以 MIT 协议发布,可商用、可修改、可再分发;前代 2.0 同为 MIT。注意 11 月初的不少报道仍称权重 "coming soon",已经过时。
LongCat 2.5 价格是多少?
限时价:输入 $0.30 / 缓存输入 $0.006 / 输出 $1.20(每百万 tokens;人民币 ¥2 / ¥0.04 / ¥8)。折扣无截止日期、无目录价,官方称「价格可能变动」。仅 HTTP 200 请求计费,预付余额永不过期。详见本站价格指南。
LongCat 2.5 怎么用?有哪些渠道?
官方聊天应用 longcat.ai/chat、LongCat API Platform(模型 ID LongCat-2.5)、Vercel AI Gateway、AnyRouter;免费路线有 OpenCode Zen(longcat-2.5-free)与 Nous Portal 免费端点。注意:不在 OpenRouter。本地部署可用已发布的 MIT 权重,但 README 只指引 NPU + SGLang-FluentLLM。
LongCat 2.5 的 AA 指数是多少?
截至 11 月 13 日,Artificial Analysis 尚未收录 LongCat 2.5,没有独立评分;AA 榜单上只有 2.0 与 Flash Lite。ArtificialWatch 11 月 13 日的报告同样写 "not rated yet"。本站会持续跟踪。
Terminal-Bench 2.1 的 88.4 分可信吗?
88.4 是美团官方自报(Claude Code v2.1.280 harness,最大序列 512K),在独立复现前应按「厂商口径」看待。警示:AA 曾测得 2.0 的 TB 2.1 为 50.2%,比美团表内 70.8 低 20 分;社区单人自测预览版 2.5 约 48.7%(不同 harness,仅作参考)。
LongCat 2.5 和 2.0 有什么区别?
两者共享底座,2.5 新增原生视觉(图像 + 视频输入)与长程 Agent 训练:Terminal-Bench 4.0 从 3.0 升至 38.5,DeepSWE 从 9.7 升至 64.6,AutomationBench 从 15.8 升至 51.8。价格反而降了:2.5 限时价 $0.30/$1.20,约为 2.0 旧目录价 $0.75/$2.95 的四成。
LongCat 2.5 和 DeepSeek V4.1 Flash 比怎么样?
两者限时价/高峰价完全相同($0.30/$1.20),但 DeepSeek 非高峰半价,月度账单更便宜;基准上 DeepSeek 领先多数编码行(DeepSWE 74.2 对 64.6、TB 2.1 90.6 对 88.4),LongCat 领先 TB 4.0(38.5 对 31.2)、BrowseComp(91.9 对 91.5)与 ProgramBench(25.5 对 20.3)。两者权重均为 MIT。详见本站三方横评。
LongCat 2.5 支持视觉和视频吗?
支持。输入可含图像(PNG/JPG/JPEG/WebP/GIF,≤10MB,≤50/请求)与视频(≤100MB,<3600 秒,≤10/请求,仅公开 URL);不支持 SVG/HEIC,长宽比 >200:1 报错。视觉为原生多层离散 token,无独立视觉编码器;输出仍为纯文本。视频理解随 11 月 2 日 GA 加入,预览版没有。
最大输出到底是 128K 还是 262K?
官方文档口径不一:Quick Start、FAQ 与美团 Claude Code 配置称 131,072(128K),Model Parameters 页称 max_tokens 可至 262,144。本站与 eesel 的建议一致:按 128K 规划,262K 未经证实。
LongCat 2.5 的上下文窗口多大?
API 口径 1,048,576 tokens(输入 + 输出合计)。权重仓库 config 的基数是 524,288,经 YaRN rope scaling 扩展到 1M;实际长上下文表现尚无独立评测验证。
11来源
本页事实均来自以下公开来源(核查于 2026 年 11 月 13 日)。
官方
- 美团 LongCat 团队 — Introducing LongCat-2.5(官方技术博客,含 31 项基准表与架构细节) 11 月 1 日
- 美团技术团队 — 美团 LongCat 2.5:长程 Agent 训练方法(长程 RL、MOPD 蒸馏、W4A4 量化) 11 月 2 日
- Hugging Face — meituan-longcat/LongCat-2.5(MIT 权重,全量 3,317.3 GB,含 config.json 与评测表) 11 月 4 日
- Hugging Face — meituan-longcat/LongCat-2.5-W4A4(W4A4 量化权重,1,244.3 GB) 11 月 4 日
- LongCat 官网 — longcat.ai(聊天应用与 API 平台入口)
英文报道与分析
- eesel — LongCat 2.5: Meituan's New Multimodal Coding Model, Explained(逐页深读官方文档) 11 月 3 日
- apiyi — What Can LongCat 2.5 Actually Do?(官方基准与价格指南) 11 月 3 日
- apiyi — LongCat 2.5 Long-Horizon Agent Training, Explained(训练方法解读)
- ToolPilotPro — LongCat-2.5 Guide(价格与折扣说明)
- ToolPilotPro — LongCat-2.5 vs Kimi K3.1 Pro vs DeepSeek(三方横评;11 月 4 日更新版仍称 API-only,已过时) 11 月 4 日更新
- OrcaRouter — LongCat 2.5 预览分析(10 月 13 日数据)
- ArtificialWatch — LongCat 2.5 报告("not rated yet") 11 月 13 日
- TokenDyno — 实时测速(OpenCode Go 约 51.8 tok/s,n=4)
- OpenVibeEval — 排行榜(2.5 Preview 第 40 名)
- TokenHeart — 新京报报道英译:万亿参数、国产加速器训练