Gemini 4 Carbon 专题
Google 自家最强模型,2026 年 11 月 10 日全面开放:主打长程 Agent 任务、复杂编程、网络安全与科学推理。API 与 Argon 同价($2/$10 至 11 月 30 日),但思考 token 更多、速度更慢;Artificial Analysis 指数 60,曾短暂登顶,两天后被 Claude Fable 5.2 超过。本页汇总官方规格、上手路线、价格与中英文首批实测,并明确标注哪些说法尚未证实。
01关键事实
先把能确认的说清楚:这是一个正式版(GA),不是限时预览;但它的「最强」头衔只维持了两天。
- 宣布 / GA
- 2026-10-28 宣布(Koray Kavukcuoglu,Google DeepMind 高级副总裁 / Google 首席 AI 架构师);2026-11-10 全面开放(GA)
- 模型 ID
gemini-4-carbon(API 稳定版标识)- 官方定位
- Google 自家最强模型:长程 Agent 工作流、复杂多步编程、网络安全、科学推理
- 基础
- 基于 Gemini 4 Argon(预训练基础 + 架构)+ 额外后训练;Google 自述「主要差异是每轮花多少思考 token」
- 上下文
- 1,048,576 tokens,输入 + 思考 + 输出共享
- 最大输出
- 65,536 tokens(流式);32,768 tokens(非流式)
- 思考模式
- 默认开启;档位 low / medium(默认)/ high;无 minimal(返回 HTTP 400);忽略 temperature、topP、topK
- 输入 / 输出
- 输入:文本、图片、音频、视频(另有 PDF);输出:文本
- 知识截止
- 2026 年 3 月(模型卡口径)
- 可用渠道
- Gemini API 付费层(AI Studio、Android Studio)、Gemini for business、Google AI Ultra(Gemini App、Search AI Mode、Antigravity);另有 OpenRouter 等第三方网关。没有免费层,Pro / Plus 订阅也用不到
- 价格
- API:$2 输入 / $10 输出(每百万 tokens,至 11 月 30 日),12 月 1 日起 $4 / $20;缓存输入 95% 折扣。Ultra 订阅 $99.99 / $199.99 每月(美国)
- 基准分
- Artificial Analysis 指数 60(High,v5.0.1);LMArena Text 1526 预览分第 1;Google 官方 17 项表 15 项第一(多项为 Google 自测,见 06C 节)
- 权重 / 许可
- 未发布;专有托管模型,不是开源模型
- 参数量
- 未披露
02时间线
从宣布到 GA 只隔了 13 天;登顶 AA 指数只维持了约两天。
- 2026-10-28
Google 在 blog.google 宣布 Gemini 4 Carbon;同日仅向 Fairwind Program 的部分网络安全防御方开放,专项网络安全配置至今仍需申请。公告称 AA 指数 v5.0 得 59 分、排名第一。
- 2026-11-03 – 05
LMArena Text 预览分约 1528,暂列第一(约 4,403 票)。
- 2026-11-07
Artificial Analysis 指数更新至 v5.0.1:Carbon(High)60 分,登顶;Opus 5.5 为 59、Astra 为 57。
- 2026-11-09
Claude Fable 5.2 发布,AA 指数 65,超过 Carbon 夺回第一;FrontierSWE v2 亦以 69.9% 领先 Carbon 的 61.2%。
- 2026-11-10
全面开放(GA):付费 API、AI Studio、Gemini for business、Ultra 订阅(Gemini App、AI Mode、Antigravity);模型卡发布;Antigravity 推出
/swarm多 Agent 预览;Cursor 当天接入。 - 2026-11-11 – 12
首批实测潮:Quantslant、虎嗅、鱼皮、SeedRouter、eesel 等中英文测评陆续发布(见第 06 节)。
- 2026-11-30
API 优惠价截止($2/$10)。
- 2026-12-01
API 价格翻倍至 $4 输入 / $20 输出(每百万 tokens)。
03官方规格
以下为官方已公布口径(模型页与模型卡,2026 年 11 月 11 日核查);未公布的项直接写明,不做推测填充。
- 状态
- GA 正式版(2026-11-10 起)
- 模型 ID
- gemini-4-carbon
- 上下文窗口
- 1,048,576 tokens(输入 + 思考 + 输出共享)
- 最大输出
- 65,536 tokens(流式);32,768(非流式)
- 思考模式
- 默认开启:low / medium(默认)/ high;无 minimal
- 输入
- 文本、图片、音频、视频(另有 PDF)
- 输出
- 文本
- 知识截止
- 2026 年 3 月
- API
- Gemini API 付费层;无免费层
- 基准分
- AA 指数 60(High,v5.0.1);LMArena 1526(预览分)
- 模型卡
- 已发布(2026-11-10)
- 参数量
- 未披露
- 权重
- 未发布
- API 价格
- $2 / $10 至 11 月 30 日;12 月 1 日起 $4 / $20(每百万 tokens)
04怎么试用:6 条路线
开发者最快的是付费 API;普通用户只有 Ultra 订阅一条路——Pro 订阅没有 Carbon。
1Gemini API 付费层(AI Studio / Android Studio)
开发者主路线。付费层 API Key 即可调用,模型 ID gemini-4-carbon;从 Argon 迁移只需改模型名,请求结构不变。免费层没有 Carbon,需要绑定账单账户并预付。
2Gemini App(Ultra 订阅)
Google AI Ultra 订阅用户在 Gemini App、Search AI Mode、Antigravity 中使用,模型选择器提供 Low / Medium / High 三档(默认 High)。Free、Plus、Pro 订阅均无。
3Gemini for business
企业路线:API 或下拉菜单调用,Antigravity 与 CodeMender 中可用。
4Antigravity + /swarm 预览
Google Antigravity 中的多 Agent 编排预览:一个提示词派出一队协调 Agent,可把 Carbon 指派给架构、协调、审计角色,搭配更快更轻的模型与对抗验证器。
5第三方网关
OpenRouter 上为 google/gemini-4-carbon,与官方同价 $2/$10,:batch 变体 $1/$5;models.dev 目录有 16 家提供商列出 Carbon。Cursor 在 11 月 10 日当天接入。
6科学家计划 / Fairwind 专项
科学家:10,000 名科学家项目入选者免费 6 个月在 Antigravity 最高用量档用 Argon + Carbon,申请开放、每周滚动入选。网络安全:专项配置仍通过 Fairwind Program 申请。
05价格解析
单价与 Argon 完全相同,但账单未必相同——Carbon 每个任务花的思考 token 更多。价格为 2026 年 11 月 11–12 日核查口径,结账页价格为准。
| API 档位(每百万 tokens) | 至 2026-11-30 | 2026-12-01 起 |
|---|---|---|
| Standard 输入 | $2.00 | $4.00 |
| Standard 输出(含思考 tokens) | $10.00 | $20.00 |
| 缓存输入(隐式缓存,95% 折扣) | $0.10 | $0.20 |
| Batch API(输入 / 输出) | $1 / $5 | $2 / $10 |
| Flex(输入 / 输出) | $1 / $5 | $2 / $10 |
| Priority(输入 / 输出) | $3.60 / $18 | $7.20 / $36 |
缓存为隐式缓存:提示不少于 4,096 tokens 时自动触发。Batch / Flex / Priority 价格引自定价页梳理(agentdeals.dev,11 月 12 日)。
订阅:Google AI Ultra
美国定价 $99.99/月(Ultra 5x,Pro 用量 5 倍)/ $199.99/月(Ultra 20x)。Ultra 在 150+ 国家销售;Carbon 覆盖 Ultra 用户的「部分国家」,Google 未列举具体名单。Pro、Plus、免费订阅均无 Carbon——这一分层在 11 月 10–11 日的 Instagram / Facebook 评论中引发付费 Pro 用户不满,不少人拿 Claude Pro 提供 Fable 5.2 作对比。
任务成本:单价便宜不等于账单便宜
Artificial Analysis 按标准价测得:Carbon(High)每任务 $7.76,约比 Claude Opus 5.5(max,$10.04)低 23%,约 1.2 倍于 GPT-6 Astra(max,$6.25);Fable 5.2(High)为 $9.08,只比 Carbon 贵 1 美元多。分档看:Medium 每任务 $6.59 反而比 Low($7.19)便宜——弱档位更容易绕圈子、耗更多 token。简单任务上 Carbon 明显更贵:同一组 11 个小任务,Carbon 默认档成本是 Argon 的 3.05 倍;但在编码 Agent 任务上,Carbon 为 $7.74/任务,反而低于 Argon 的 $11.73。
官方页面:Gemini API 定价页 · Google 11 月 10 日 GA 公告
06首批实测与测评
以下全部是 11 月 10–13 日的首批上手实测:样本小、方法不一,请按「个案」看待。每条都给出结论徽章;点「阅读本站全文」进入本站的深度改写文章页,文末附原始出处。
英文来源
Quantslant:50+ 任务四模型对比
结论:日常无优势,编码是短板来源:Quantslant,2026-11-11(vs Argon、Fable 5.2、GPT-6.1 Sol,同设置、单元测试评分)
23 项实用任务 Carbon 99.5%($0.23,264 秒),与 Argon 持平但慢一倍;Agent、电子表格(34/34)、安全审查(8/8)、SOC 日志(7/7)全部满分。但 6 项编码任务、76 个单元测试中 Carbon 仅 63/76,三位对手全部 76/76。另有思考烧光 Bug:正则任务 medium 档用掉全部 16,000 tokens 推理,未返回代码。
阅读本站全文 → (本站原创整理)
SeedRouter 与老张博客:Carbon vs Argon
结论:同价不同账,难活才划算来源:SeedRouter / blog.laozhang.ai,2026-11-11
同提示词测试:两者答案都对,但 Carbon 计费输出 token 多约 44%(小样本);11 个小任务上 Carbon 成本是 Argon 的 3.05 倍、耗时 2.75 倍。反过来:1,500 行日志精确计数,Argon 22 秒答错,Carbon 214 秒答对;编码 Agent 任务上 Carbon 每任务 $7.74,反而低于 Argon 的 $11.73。Google 的建议:交互式编程用 Argon,Argon 答错时换 Carbon。
阅读本站全文 → (本站原创整理)
eesel.ai 与 Inferera:思考档位与避坑指南
结论:medium 最划算,低上限会空手而归来源:eesel.ai / Inferera,2026-11-11/12
AA 三档数据:Low 54 分、$7.19/任务、编造率 20%;Medium 58 分、$6.59/任务、编造率 4.2%(最便宜也最诚实);High 60 分、$7.76/任务、编造率 11%。代价是时间:首个词约等 1 分钟,high 档每基准任务约 26 分钟。API 侧:thinking_budget、minimal 档、candidate_count>1 均返回 400;低输出上限会静默截断思考、返回空文本且照样收费;建议 HTTP 超时 15–20 分钟。
阅读本站全文 → (本站原创整理)
基准盘点:Google 官方表 + 独立榜单
结论:分数亮眼,但要看谁测的来源:Google 官方 10 月 28 日分数表;Artificial Analysis;LMArena,2026-11-07/12
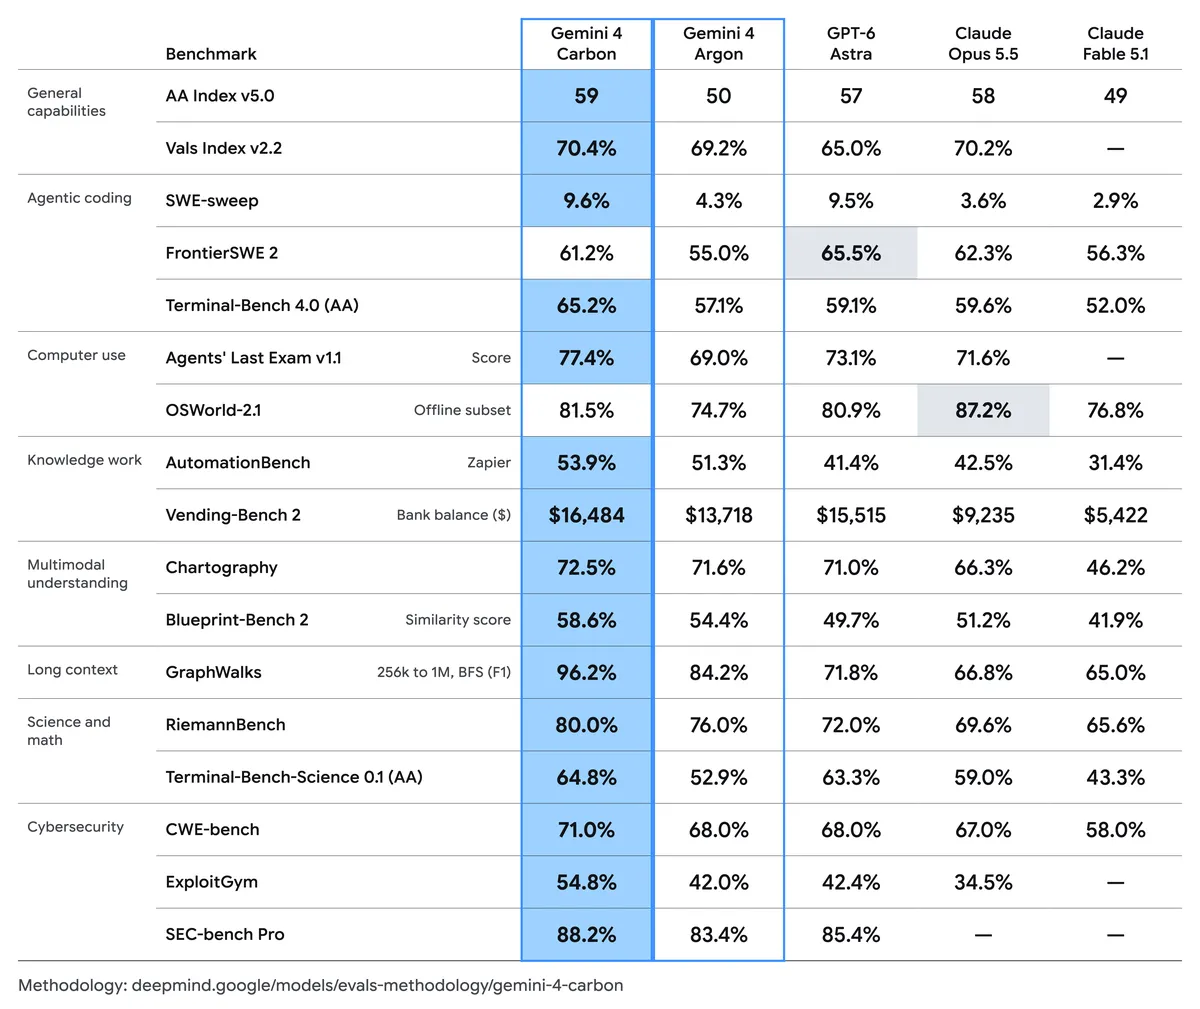
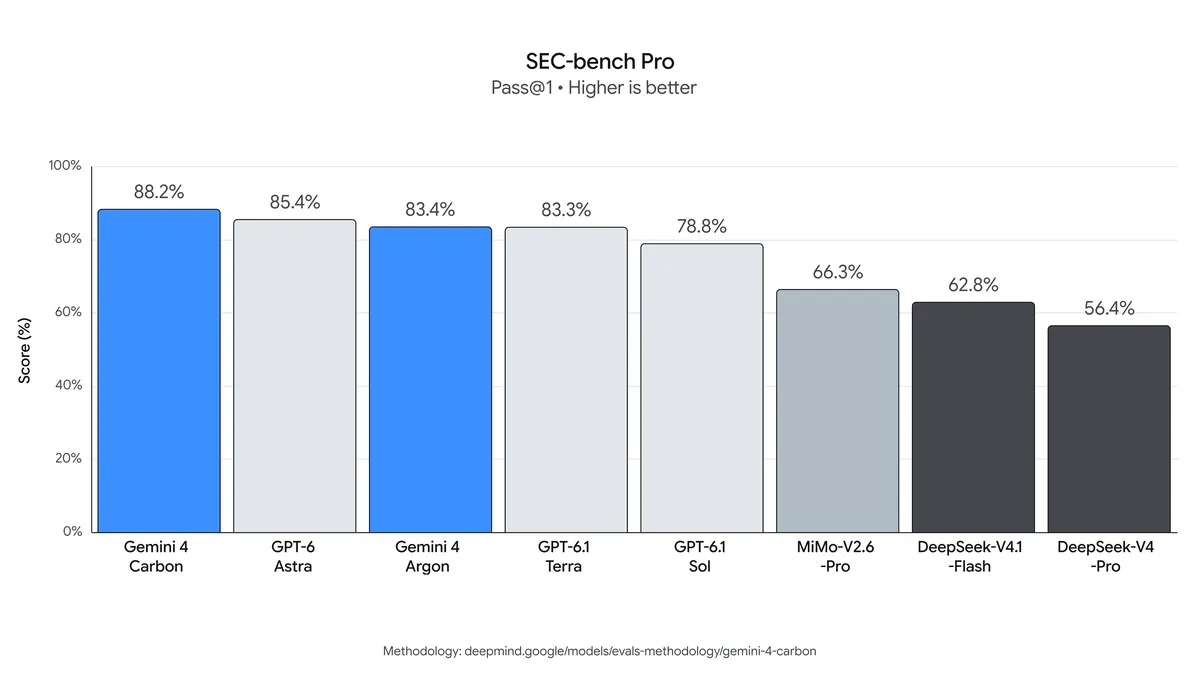
Google 官方 17 项表:Carbon 15 项第一,只输 FrontierSWE 2(61.2%,低于 Astra 的 65.5%)与 OSWorld-2.1(81.5%,低于 Opus 5.5 的 87.2%)。但多项分数由 Google 自行计算,安全测试在无网、防护关闭环境下进行,且对比的是上一代 Fable 5.1。独立榜单:AA 指数 60(11 月 7 日登顶,11 月 9 日被 Fable 5.2 的 65 超过)、LMArena 1526 预览分第一、WebDev Arena 第 4。
阅读本站全文 → (本站原创整理)
AI for Mortals:四模型同场建造测试
结论:建造垫底,但最便宜来源:AI for Mortals(Pat Simmons),2026-11-12/13(同一提示词、最高努力档,每模型只跑一次)
三项建造任务对上 Fable 5.2、Opus 5.5 与 GPT-6 Astra:网站像素级克隆第 4($10.86,99 分钟)、Motion 宣传片第 4($6.82,68 分钟)、1940 年代空战飞行模拟第 3($10.00,102 分钟)。但三项合计只花 $27.68,Fable 5.2 高达 $883.30;作者提醒 12 月 1 日涨价后省钱优势会缩水,且 Fable 的飞行模拟日志有部分丢失、成本可能被低估。
阅读本站全文 → (本站原创整理)
中文来源
虎嗅:Antigravity 九项测试
结论:交付稳定,「不再偷懒」来源:虎嗅,2026-11-11(Antigravity,High 档,全部一次成型)
9 个任务没有一项彻底失败:户型图变可漫游 3D 楼栋(约 1 小时)、iPhone Duo 交互 3D 展品、手写布料物理丝绸卷轴、逐帧复刻 20 秒宣传片(37 个硬切与原片一致)、8D 重庆夜景等。短板是精细度:家具简单、材质重复、屏幕内容超出圆角机身;15 秒艺术史第一版还「作弊」调用了图像生成。作者认为 Google 不再宣称「最强」,转而强调任务成本不到第二名一半、价格约 Fable 5.2 的四分之一。
阅读本站全文 → (本站原创整理)
鱼皮:三道前端题 vs Fable 5.2
结论:失望,审美与稳定性差一档来源:腾讯云开发者社区,2026-11-11(Cursor,3 个并行子 Agent,High 档,复用 Fable 5.2 同题)
「上古卷轴」被服务端错误 3 次打断,耗时 2 小时 16 分钟(Fable 5.2 为 86 分钟、零中断);重庆 8D 城市生成器 34 分钟交卷但只有 184 栋方盒子楼(Fable 5.2 为 1,230 栋);溶洞项目第一轮近 2 小时后作废重来,大黄狗是圆柱拼的、镜头会穿进岩壁。3 个项目共花 $21.30,远低于 Fable 5.2 的 500 多块;作者结论:「不要完全相信跑分」。
阅读本站全文 → (本站原创整理)
06B文章目录:本站深度解读
以下 8 篇均为本站原创改写与再整理的深度文章——重新组织结构、补充结论与选型建议,事实与数据与原始测评核对一致。点击任意一篇在本站内阅读,文末附原始出处。
06C基准测试:官方表 + 独立榜单
Carbon 与 Qwen4-Max 相反:分数很多,问题是谁测的、跟谁比。下面先给 Google 官方 17 项表(2026-10-28),再给独立榜单,最后说 caveat。
| 测试(Google 官方表) | Carbon | Argon | GPT-6 Astra | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|---|
| AA Index v5.0 | 59 | 50 | 57 | 58 | 49 |
| Vals Index v2.2 | 70.4% | 69.2% | 65.0% | 70.2% | — |
| SWE-sweep | 9.6% | 4.3% | 9.5% | 3.6% | 2.9% |
| FrontierSWE 2 | 61.2% | 55.0% | 65.5% | 62.3% | 56.3% |
| Terminal-Bench 4.0 (AA) | 65.2% | 57.1% | 59.1% | 59.6% | 52.0% |
| Agents' Last Exam v1.1 | 77.4% | 69.0% | 73.1% | 71.6% | — |
| OSWorld-2.1(离线) | 81.5% | 74.7% | 80.9% | 87.2% | 76.8% |
| AutomationBench (Zapier) | 53.9% | 51.3% | 41.4% | 42.5% | 31.4% |
| Vending-Bench 2(美元余额) | 16,484 | 13,718 | 15,515 | 9,235 | 5,422 |
| Chartography | 72.5% | 71.6% | 71.0% | 66.3% | 46.2% |
| Blueprint-Bench 2 | 58.6% | 54.4% | 49.7% | 51.2% | 41.9% |
| GraphWalks 256K–1M | 96.2% | 84.2% | 71.8% | 66.8% | 65.0% |
| RiemannBench | 80.0% | 76.0% | 72.0% | 69.6% | 65.6% |
| Terminal-Bench-Science 0.1 (AA) | 64.8% | 52.9% | 63.3% | 59.0% | 43.3% |
| CWE-bench | 71.0% | 68.0% | 68.0% | 67.0% | 58.0% |
| ExploitGym | 54.8% | 42.0% | 42.4% | 34.5% | — |
| SEC-bench Pro | 88.2% | 83.4% | 85.4% | — | — |
Carbon 15/17 第一。官方表对比的是上一代 Claude Fable 5.1,而非 11 月 9 日发布的 Fable 5.2。
独立榜单与第三方测量
| 测量 | 来源 | Carbon 成绩 | 对照 |
|---|---|---|---|
| AA 智能指数 v5.0.1 | Artificial Analysis,11 月 7 日 | 60.0(High),曾登顶 | Fable 5.2 65(11 月 9 日起居首);Opus 5.5 59;Astra 57;Argon 50 |
| AA 指数分档 | Artificial Analysis / eesel,11 月 11 日 | Low 54 / Medium 58.3 / High 60 | Medium 每任务 $6.59 最便宜,编造率 4.2% 最低 |
| AA-Omniscience v1.1 | Artificial Analysis,约 10 月 31 日 | 净分 54,第 1 | Opus 5.5 48;准确率 58%(Argon 48%);幻觉率 11%(Argon 4%) |
| LMArena Text | LMArena,11 月 6–7 日 | 1526 预览分,第 1(约 4,483 票) | Argon(High)1523;Muse Wonder 1513;Opus 5.5 1505 |
| WebDev Arena | LMArena | 1768 elo,第 4 | — |
| CursorBench 4.0 | Cursor | 第 1(high 档 60.4%) | — |
| Coding Agent Index | Artificial Analysis | 59 | Claude Code + Opus 5.5 为 62,Carbon 落后 3 分 |
| MKA(多模态知识 Agent) | Google × AA 合作新基准 | 第 2 | 平均任务成本不到第一名的 1/6 |
| FrontierSWE v2 | Snowtraces,11 月 11 日 | 61.2% | Fable 5.2 69.9% |
| UL37(对象检测自动标注) | Ultralytics,11 月 11 日 | 0.584 mAP50,45 个模型中第 1 | 精确度 0.685 与召回率 0.642 均为第 1;但每千张图 $12.93,约 3 倍于 GPT-6.1 Terra;甲状腺超声与电路板缺陷是短板 |
| AA 指数时间与成本 | OrcaRouter,11 月 13 日 | 首 token 64.7 秒(77 模型中第 69)、每任务 28.4 分钟、跑一轮指数 $5.48 | 网关实测 p50 6.89 秒;OrcaRouter 流量报错率 39.7%(Fable 5.2 为 10.8%) |
完整盘点见本站基准测试专文 →
07对比
vs Gemini 4 Argon(同门上一档)
| 维度 | Gemini 4 Carbon | Gemini 4 Argon |
|---|---|---|
| 状态 | GA(2026-11-10) | GA(更早发布) |
| API 价格 | $2 / $10 至 11 月 30 日,之后 $4 / $20 | 与 Carbon 完全相同 |
| 上下文 | 1M | 1M |
| AA 指数 | 60(High)/ 58(Medium)/ 54(Low) | 50(High) |
| 速度 | 慢:每任务约 26–27 分钟,首 token 约 68 秒 | 快得多:同组任务约一半时间 |
| 订阅 | 仅 Ultra | Pro 及以上可用 |
| 适合 | 最难的任务:长程 Agent、疑难调试、科学推理、安全审查 | 大多数编程与知识工作、交互式编程、快速循环 |
Google 自己的建议:Argon 仍是大多数软件工程与知识工作的正确选择;Carbon 留给最难的任务。
vs 竞品旗舰(Artificial Analysis 指数,2026-11-12 口径)
| 模型 | API 价格 $/百万(入/出) | AA 指数 | 上下文 |
|---|---|---|---|
| Claude Fable 5.2 | 8 / 40 | 65(max) | 1M |
| Gemini 4 Carbon | 2 / 10(至 11 月 30 日) | 60(high) | 1M |
| Claude Opus 5.5 | — | 59(max) | — |
| GPT-6 Astra | 10 / 50 | 57(max) | 1.05M |
| GPT-6.1 Sol | 2 / 10 | 55(max) | 1.05M |
| Qwen3.8 Max | 2 / 6 | 45(09-27) | 1M |
| Qwen4-Max-Preview | 仅 Token Plan 订阅 | 未收录 | 1M |
08还缺什么(截至 11 月 13 日)
- 参数量与架构细节(Google 未披露)
- Vertex AI 可用性(GA 公告材料未说明)
- 分国家推出时间表;Ultra 覆盖 Carbon 的具体国家名单
- Ultra 5x / 20x 的具体用量上限(只确认了价格与倍数)
- Google 自测基准的独立复现(官方表多项为 Google 自行计算)
- /swarm 多 Agent 编排的正式版日期(目前为预览)
- 长期稳定性数据(GA 首日有测试者遇到多次服务端错误,属个案)
- 12 月 1 日之后更远期的价格计划
09谣言核查
Carbon 没有出现大规模谣言潮,但以下说法正在流传或容易混淆,需要逐条澄清。
已澄清 「Carbon 的 AA 指数到底是 59 还是 60?」
都是真的,只是版本不同:59 是 AA 指数 v5.0(10 月 28 日公告时),60 是 v5.0.1(11 月 7 日更新后)。引用时请注明版本。
不成立 「Carbon 是 AA 指数第一」
曾是,但只维持约两天(11 月 7–9 日)。11 月 9 日 Claude Fable 5.2 发布后以 65 分居首,截至 11 月 12 日 Carbon 60 分居其后。另注意:不同统计口径(按模型 / 按配置)给出的 Carbon 排名在 2–4 位之间,本页不写单一排名数字。
不成立 「Carbon 击败了 Fable 5.2」
AA 指数(65 对 60)、FrontierSWE v2(69.9% 对 61.2%)均为 Fable 5.2 领先。Google 官方对比表用的是上一代 Fable 5.1——这张表发布时 Fable 5.2 还未发布,但现在拿它论证「Carbon 最强」已经过时。
部分成立 「Carbon 只是 Argon 加了更多思考」
Google 自述 Carbon 基于 Argon 的预训练基础与架构,「主要差异是每轮花多少思考 token」,且单价完全相同。但这不等于「同一个模型」:额外后训练带来了实质改进——作弊尝试 3.6%→0.4%(成功 2.4%→0%)、Agent 诚实基准 70%→92%、AA 指数 50→60。
不成立 「AI Studio 免费层 / Pro 订阅能用 Carbon」
定价页明确 Carbon 不在免费层;Google AI Pro 订阅同样没有,Pro 仍为 Argon。消费者侧只有 Ultra 订阅能用。
10FAQ
Gemini 4 Carbon 什么时候发布的?
2026 年 10 月 28 日宣布,11 月 10 日全面开放(GA)。10 月 28 日至 11 月 10 日之间仅开放给 Fairwind Program 的部分网络安全防御方。时间线见本页第 02 节。
Gemini 4 Carbon 免费吗?
不免费。API 没有免费层;消费者侧只有 Google AI Ultra 订阅($99.99 / $199.99 每月,美国)能用,Pro、Plus、免费订阅均无。科学家计划入选者可免费使用 6 个月。
API 价格是多少?12 月 1 日之后会涨吗?
至 11 月 30 日:输入 $2 / 输出 $10(每百万 tokens,含思考 tokens);12 月 1 日起翻倍至 $4 / $20。缓存输入 95% 折扣($0.10 → $0.20)。Batch 与 Flex 为半价。价格见本页第 05 节。
它比 Argon 强在哪?日常用该选谁?
AA 指数 60 对 50,安全与诚实指标明显更好;但日常任务上它做不了 Argon 做不了的事,还更慢更贵。Google 的建议:交互式编程与大多数知识工作用 Argon;Argon 答错或漏东西时换 Carbon。详见本站Carbon vs Argon 对比。
它比 Claude Fable 5.2 强吗?
按分数不强:AA 指数 65 对 60、FrontierSWE v2 69.9% 对 61.2%,均为 Fable 5.2 领先;前端实测中 Fable 5.2 的审美与稳定性也更好;11 月 13 日 AI for Mortals 的三项同场建造测试中,Carbon 在网站克隆与宣传片两项垫底、飞行模拟第三,Fable 5.2 在网站克隆第一。但 Carbon 单价只有 Fable 5.2 的四分之一,任务成本 $7.76 对 $9.08,差距只有 1 美元多。
思考档位 low / medium / high 怎么选?
默认 medium 是最划算的档:AA 58 分、每任务 $6.59、编造率 4.2%(三档中最低);High 60 分但每任务 $7.76、编造率 11%;Low 54 分、每任务 $7.19、编造率 20%。详见本站思考档位与避坑指南。
为什么我的请求返回了空答案还扣了费?
输出上限覆盖思考 token:上限设太低时,模型把 token 全花在思考上、还没写答案就触顶,返回空文本、状态 incomplete,费用照收。这是已确认的行为(Quantslant 实测、Google 文档均有说明),不是偶发故障。解决办法:把 max_output_tokens 设到至少 32,768,用思考档位而不是输出上限控成本。
上下文窗口多大?
1,048,576 tokens,输入、思考与输出共享。最大输出 65,536 tokens(流式)或 32,768(非流式)。
它是开源的吗?HuggingFace 上有吗?
不是开源模型,没有发布权重,HuggingFace 上没有官方模型。只能通过 Google API 与订阅服务使用。
Vertex AI 上能用吗?
GA 公告材料未说明 Vertex AI 的可用性,截至 11 月 13 日没有确认消息。请以 Google Cloud 官方文档为准。
去哪里看最新状态?
Google 官方博客(blog.google)、Gemini API 定价页与模型页、Artificial Analysis 模型页,以及本页下方的来源列表。
11来源
本页事实均来自以下公开来源(核查于 2026 年 11 月 12–13 日)。
官方
- Google 官方博客 — Gemini 4 Carbon is now available 11 月 10 日
- Gemini API — 定价页
- Artificial Analysis — Gemini 4 Carbon 模型页
英文报道与实测
- Quantslant — Gemini 4 Carbon available: price, access, first test 11 月 11 日
- Quantslant — Gemini 4 Carbon test(50+ 任务四模型对比) 11 月 11 日
- eesel.ai — Gemini 4 Carbon review 11 月 11 日
- SeedRouter — Gemini 4 Carbon vs Argon 11 月 11 日
- 老张博客 — Carbon vs Argon: When Slower Carbon Pays Off 11 月 11 日
- 老张博客 — Gemini 4 Carbon Release Date 11 月 11 日
- Inferera — Carbon API Migration: 400 Errors, Timeouts and Output Limits 11 月 12 日
- BenchLeader — AA Intelligence Index 榜单 11 月 12 日数据
- TrendyTechTribe — Price, Access, /swarm and Benchmarks 11 月 11 日
- Lindy — Gemini 4 Carbon: Who Can Use It, Pricing, and Benchmarks 11 月 12 日
- AI for Mortals — Gemini 4 Carbon: No-Hype Full Review & Testing(四模型同场建造测试) 11 月 12–13 日
- OrcaRouter — Gemini 4 Carbon Benchmark: What 60 on AA v5.0.1 Actually Measures(AA 60 分解读) 11 月 13 日
- Ultralytics — Gemini 4 Carbon Auto-Annotation: UL37 Benchmark(45 个模型中第 1) 11 月 11 日