Gemini 4 Carbon 基准测试全盘点:官方 17 项表、AA 60 分与 LMArena 1526 怎么看
搜「Gemini 4 Carbon benchmark」的人会发现:分数很多,而且互相打架——官方表说 17 项里 15 项第一,AA 指数说 60 分,LMArena 说 1526,还有人说它「输给了 Fable 5.2」。这些说法可以同时成立,关键是分清谁测的、跟谁比、什么版本。本站把全部可核查分数盘点如下,先说总判断:Carbon 是顶级模型,但不是榜单第一;它的真正优势在长上下文、安全与任务成本,而非通用智能的绝对峰值。
Google 官方 17 项表(2026-10-28)
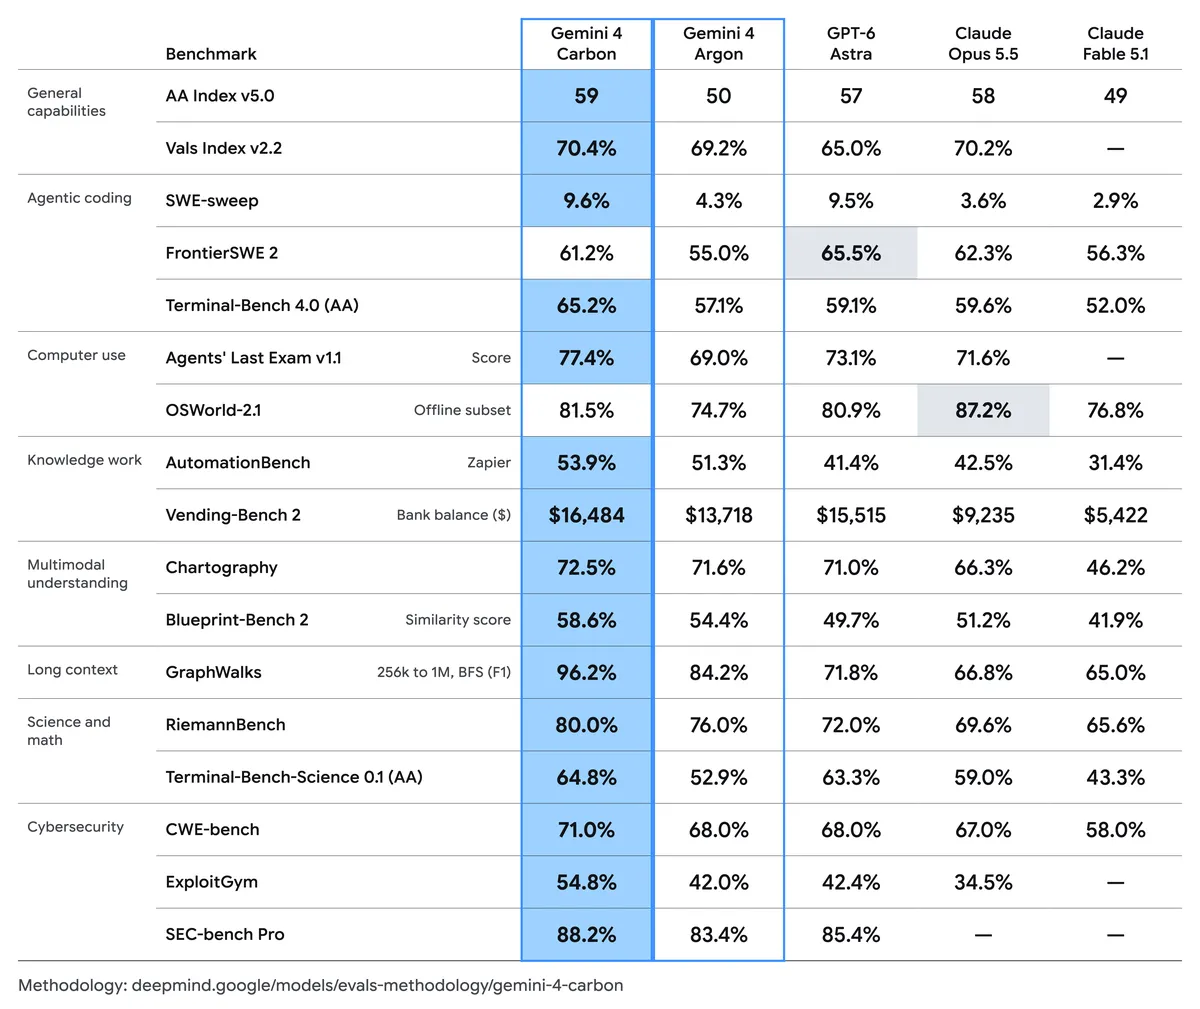
公告当天发布的官方对比表,Carbon 15/17 第一,只输两项:
| 测试 | Carbon | Argon | GPT-6 Astra | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|---|
| AA Index v5.0 | 59 | 50 | 57 | 58 | 49 |
| Vals Index v2.2 | 70.4% | 69.2% | 65.0% | 70.2% | — |
| SWE-sweep | 9.6% | 4.3% | 9.5% | 3.6% | 2.9% |
| FrontierSWE 2 | 61.2% | 55.0% | 65.5% | 62.3% | 56.3% |
| Terminal-Bench 4.0 (AA) | 65.2% | 57.1% | 59.1% | 59.6% | 52.0% |
| Agents' Last Exam v1.1 | 77.4% | 69.0% | 73.1% | 71.6% | — |
| OSWorld-2.1(离线) | 81.5% | 74.7% | 80.9% | 87.2% | 76.8% |
| AutomationBench (Zapier) | 53.9% | 51.3% | 41.4% | 42.5% | 31.4% |
| Vending-Bench 2(美元余额) | 16,484 | 13,718 | 15,515 | 9,235 | 5,422 |
| Chartography | 72.5% | 71.6% | 71.0% | 66.3% | 46.2% |
| Blueprint-Bench 2 | 58.6% | 54.4% | 49.7% | 51.2% | 41.9% |
| GraphWalks 256K–1M | 96.2% | 84.2% | 71.8% | 66.8% | 65.0% |
| RiemannBench | 80.0% | 76.0% | 72.0% | 69.6% | 65.6% |
| Terminal-Bench-Science 0.1 (AA) | 64.8% | 52.9% | 63.3% | 59.0% | 43.3% |
| CWE-bench | 71.0% | 68.0% | 68.0% | 67.0% | 58.0% |
| ExploitGym | 54.8% | 42.0% | 42.4% | 34.5% | — |
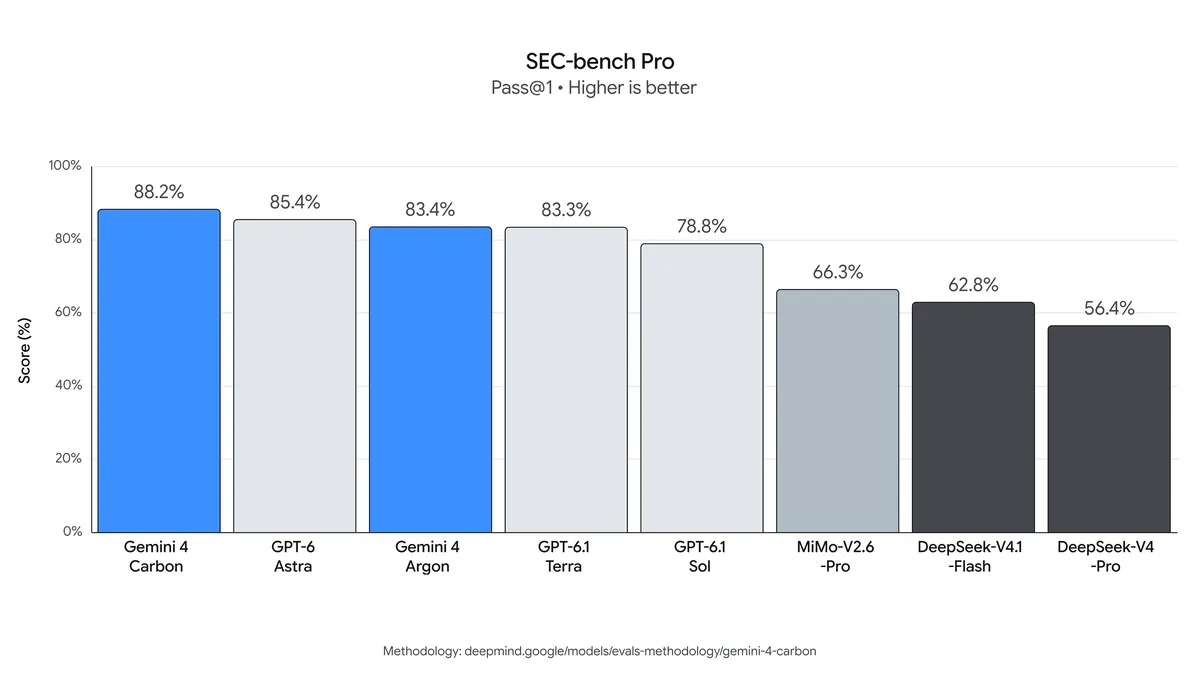
| SEC-bench Pro | 88.2% | 83.4% | 85.4% | — | — |
最值得注意的两处:GraphWalks 256K–1M 的 96.2% 是全表最大领先(第二名 Argon 只有 84.2%),印证了 Carbon 在超长上下文检索上的定位;SEC-bench Pro 的 88.2% 与 ExploitGym 的 54.8% 则支撑了它的网络安全卖点。但这张表有三个口径问题:多项分数由 Google 自行计算(SWE-sweep、Agents' Last Exam、OSWorld、GraphWalks、ExploitGym、SEC-bench Pro);安全测试在 Antigravity 内无网、防护关闭的环境下运行;竞品数字取自对方报告而非同场运行。AA 59/58/57、Vals 70.4/70.2 这类小差距基本等于平局。最重要的是:这张表对比的是上一代 Fable 5.1——发布时 Fable 5.2 还不存在。
AA 指数:60 分,登顶两天
Artificial Analysis 智能指数是目前最受关注的独立综合榜。时间线很关键:10 月 28 日公告时,Google 引用 v5.0 的 59 分称第一;11 月 7 日指数更新至 v5.0.1,Carbon(High)60.0 分登顶,Opus 5.5 为 59、Astra 为 57;11 月 9 日 Fable 5.2 发布,以 64.6 分(约 65)超过。截至 11 月 12 日,Carbon 60.0 分居 Fable 5.2 之后。分档看:Low 54、Medium 58.3、High 60。Carbon 在 9 项子评估中的 4 项拿最高分:HLE-Diamond、Terminal-Bench-Science、AA-Omniscience、AutomationBench-AA。关于排名的一个提醒:不同统计口径(按模型计 / 按 122 个配置计)给出的 Carbon 排名在 2–4 位之间,本站只写分数与前后名次。
其他独立测量
LMArena Text:Carbon(High)1526 预览分第一(11 月 6–7 日,约 4,483 票),此前为 1528(11 月 3–5 日);第二名 Argon(High)1523,两者在误差范围内重叠。WebDev Arena:第 4,1768 elo。AA-Omniscience v1.1(幻觉与知识可靠性):Carbon(high)净分 54 第一,Opus 5.5 为 48;准确率 58%(Argon 48%),但幻觉率 11% 高于 Argon 的 4%——最低幻觉率属于 Argon。CursorBench 4.0:第一(high 档 60.4%)。Perplexity WANDR 与 Zapier AutomationBench:均第一,任务成本不到次佳外部模型的一半(Google 口径)。MKA 多模态知识 Agent 基准(Google 与 AA 合作):Carbon 第二,平均任务成本不到第一名的六分之一。Coding Agent Index(AA):Carbon 59,对 Claude Code + Opus 5.5 的 62,落后 3 分——这是 Carbon 少数几个明确落后的独立榜单之一。FrontierSWE v2:Fable 5.2 69.9%,Carbon 61.2%。
安全与诚实:Carbon 最硬的分数
如果说通用智能榜单上 Carbon 只是「顶级之一」,安全与诚实指标上它领先得更实在(均为 Google 公告口径,尚未有独立复现):模拟网络攻击测试拦截 99% 攻击轨迹,单次尝试突破率 0.8%(Argon 3.1%);Gray Swan 自动网络攻击查询成功率 2.17%(Argon 9.86%);Trajectory Labs 在 132 小时 / 13,000+ 请求中零新的通用越狱;Gray Swan IPI 提示注入基准攻击成功率 0%(首次);Agent 诚实基准 92% 通过(Argon 70%);Terminal-Bench 4.0 作弊审计中,作弊尝试 3.6%→0.4%、成功作弊 2.4%→0%。
UL37 对象检测自动标注:45 个模型中第一,但贵三倍
Ultralytics 的 UL37 基准(36 个真实对象检测数据集、每集 10 张图)在 11 月 11 日给出一个 Carbon 的新标签:最强的自动标注模型。Carbon 以 0.584 mAP50 在 45 个模型中第一,mAP50-95 0.371、精确度 0.685、召回率 0.642 也全部第一;上一任榜首 GPT-6.1 Terra 为 0.560。对 Argon 则是 0.584 对 0.537,36 个数据集里 22 胜 11 负 3 平。但有两个代价:每 1,000 张图 $12.93,约 3 倍于 Terra 的 $4.36,12 月 1 日涨价后约 $25.87;以及 5 个数据集上比最强模型低 0.2 以上——甲状腺超声(0.537 对 Terra 的 0.935)、电路板缺陷 DeepPCB(0.03,排第 7)。作者的判断:标注质量优先时选 Carbon,预算优先时选 Terra。注意每个数据集只有 10 张图,单项分数只能当信号,不能当结论。
相关文章
参考来源:本文为本站原创改写与整理,事实与数据核对自 Quantslant 完整官方分数表与 Artificial Analysis 榜单(2026-11-11/12)与 Ultralytics UL37 基准(2026-11-11)
← 返回 Gemini 4 Carbon 专题