Gemini 4 Carbon 基準測試全盤點:官方 17 項表、AA 60 分與 LMArena 1526 怎麼看
搜「Gemini 4 Carbon benchmark」的人會發現:分數很多,而且互相打架——官方表說 17 項裏 15 項第一,AA 指數說 60 分,LMArena 說 1526,還有人說它「輸給了 Fable 5.2」。這些說法可以同時成立,關鍵是分清誰測的、跟誰比、什麼版本。本站把全部可覈查分數盤點如下,先說總判斷:Carbon 是頂級模型,但不是榜單第一;它的真正優勢在長上下文、安全與任務成本,而非通用智能的絕對峯值。
Google 官方 17 項表(2026-10-28)
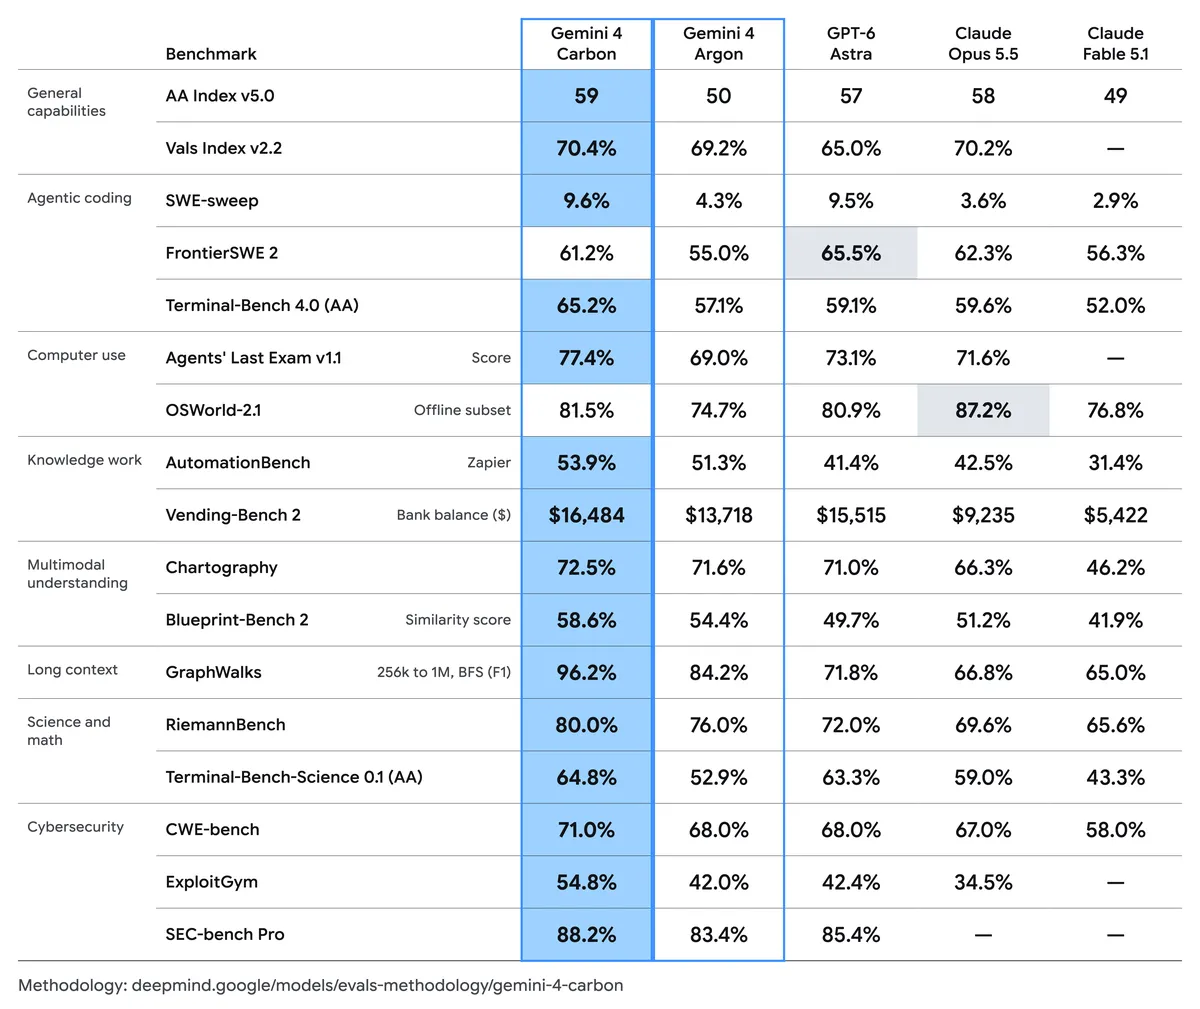
公告當天發佈的官方對比表,Carbon 15/17 第一,只輸兩項:
| 測試 | Carbon | Argon | GPT-6 Astra | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|---|
| AA Index v5.0 | 59 | 50 | 57 | 58 | 49 |
| Vals Index v2.2 | 70.4% | 69.2% | 65.0% | 70.2% | — |
| SWE-sweep | 9.6% | 4.3% | 9.5% | 3.6% | 2.9% |
| FrontierSWE 2 | 61.2% | 55.0% | 65.5% | 62.3% | 56.3% |
| Terminal-Bench 4.0 (AA) | 65.2% | 57.1% | 59.1% | 59.6% | 52.0% |
| Agents' Last Exam v1.1 | 77.4% | 69.0% | 73.1% | 71.6% | — |
| OSWorld-2.1(離線) | 81.5% | 74.7% | 80.9% | 87.2% | 76.8% |
| AutomationBench (Zapier) | 53.9% | 51.3% | 41.4% | 42.5% | 31.4% |
| Vending-Bench 2(美元餘額) | 16,484 | 13,718 | 15,515 | 9,235 | 5,422 |
| Chartography | 72.5% | 71.6% | 71.0% | 66.3% | 46.2% |
| Blueprint-Bench 2 | 58.6% | 54.4% | 49.7% | 51.2% | 41.9% |
| GraphWalks 256K–1M | 96.2% | 84.2% | 71.8% | 66.8% | 65.0% |
| RiemannBench | 80.0% | 76.0% | 72.0% | 69.6% | 65.6% |
| Terminal-Bench-Science 0.1 (AA) | 64.8% | 52.9% | 63.3% | 59.0% | 43.3% |
| CWE-bench | 71.0% | 68.0% | 68.0% | 67.0% | 58.0% |
| ExploitGym | 54.8% | 42.0% | 42.4% | 34.5% | — |
| SEC-bench Pro | 88.2% | 83.4% | 85.4% | — | — |
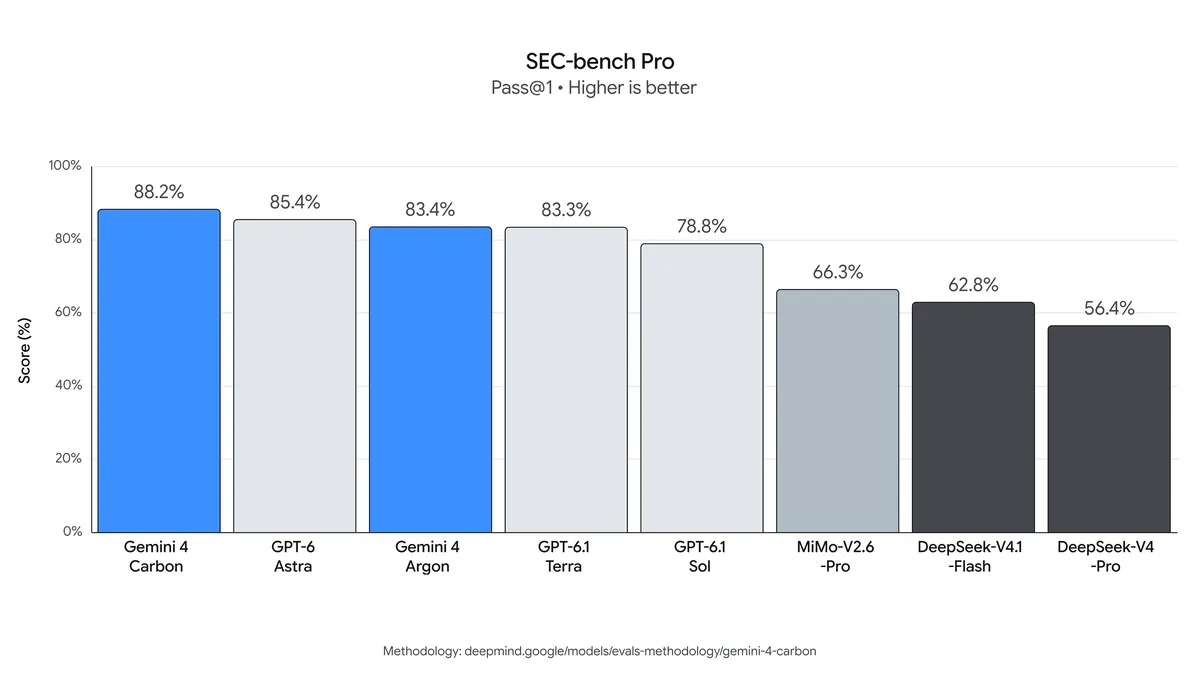
最值得注意的兩處:GraphWalks 256K–1M 的 96.2% 是全表最大領先(第二名 Argon 只有 84.2%),印證了 Carbon 在超長上下文檢索上的定位;SEC-bench Pro 的 88.2% 與 ExploitGym 的 54.8% 則支撐了它的網絡安全賣點。但這張表有三個口徑問題:多項分數由 Google 自行計算(SWE-sweep、Agents' Last Exam、OSWorld、GraphWalks、ExploitGym、SEC-bench Pro);安全測試在 Antigravity 內無網、防護關閉的環境下運行;競品數字取自對方報告而非同場運行。AA 59/58/57、Vals 70.4/70.2 這類小差距基本等於平局。最重要的是:這張表對比的是上一代 Fable 5.1——發佈時 Fable 5.2 還不存在。
AA 指數:60 分,登頂兩天
Artificial Analysis 智能指數是目前最受關注的獨立綜合榜。時間線很關鍵:10 月 28 日公告時,Google 引用 v5.0 的 59 分稱第一;11 月 7 日指數更新至 v5.0.1,Carbon(High)60.0 分登頂,Opus 5.5 爲 59、Astra 爲 57;11 月 9 日 Fable 5.2 發佈,以 64.6 分(約 65)超過。截至 11 月 12 日,Carbon 60.0 分居 Fable 5.2 之後。分檔看:Low 54、Medium 58.3、High 60。Carbon 在 9 項子評估中的 4 項拿最高分:HLE-Diamond、Terminal-Bench-Science、AA-Omniscience、AutomationBench-AA。關於排名的一個提醒:不同統計口徑(按模型計 / 按 122 個配置計)給出的 Carbon 排名在 2–4 位之間,本站只寫分數與前後名次。
其他獨立測量
LMArena Text:Carbon(High)1526 預覽分第一(11 月 6–7 日,約 4,483 票),此前爲 1528(11 月 3–5 日);第二名 Argon(High)1523,兩者在誤差範圍內重疊。WebDev Arena:第 4,1768 elo。AA-Omniscience v1.1(幻覺與知識可靠性):Carbon(high)淨分 54 第一,Opus 5.5 爲 48;準確率 58%(Argon 48%),但幻覺率 11% 高於 Argon 的 4%——最低幻覺率屬於 Argon。CursorBench 4.0:第一(high 檔 60.4%)。Perplexity WANDR 與 Zapier AutomationBench:均第一,任務成本不到次佳外部模型的一半(Google 口徑)。MKA 多模態知識 Agent 基準(Google 與 AA 合作):Carbon 第二,平均任務成本不到第一名的六分之一。Coding Agent Index(AA):Carbon 59,對 Claude Code + Opus 5.5 的 62,落後 3 分——這是 Carbon 少數幾個明確落後的獨立榜單之一。FrontierSWE v2:Fable 5.2 69.9%,Carbon 61.2%。
安全與誠實:Carbon 最硬的分數
如果說通用智能榜單上 Carbon 只是「頂級之一」,安全與誠實指標上它領先得更實在(均爲 Google 公告口徑,尚未有獨立復現):模擬網絡攻擊測試攔截 99% 攻擊軌跡,單次嘗試突破率 0.8%(Argon 3.1%);Gray Swan 自動網絡攻擊查詢成功率 2.17%(Argon 9.86%);Trajectory Labs 在 132 小時 / 13,000+ 請求中零新的通用越獄;Gray Swan IPI 提示注入基準攻擊成功率 0%(首次);Agent 誠實基準 92% 通過(Argon 70%);Terminal-Bench 4.0 作弊審計中,作弊嘗試 3.6%→0.4%、成功作弊 2.4%→0%。
UL37 對象檢測自動標註:45 個模型中第一,但貴三倍
Ultralytics 的 UL37 基準(36 個真實對象檢測數據集、每集 10 張圖)在 11 月 11 日給出一個 Carbon 的新標籤:最強的自動標註模型。Carbon 以 0.584 mAP50 在 45 個模型中第一,mAP50-95 0.371、精確度 0.685、召回率 0.642 也全部第一;上一任榜首 GPT-6.1 Terra 爲 0.560。對 Argon 則是 0.584 對 0.537,36 個數據集裏 22 勝 11 負 3 平。但有兩個代價:每 1,000 張圖 $12.93,約 3 倍於 Terra 的 $4.36,12 月 1 日漲價後約 $25.87;以及 5 個數據集上比最強模型低 0.2 以上——甲狀腺超聲(0.537 對 Terra 的 0.935)、電路板缺陷 DeepPCB(0.03,排第 7)。作者的判斷:標註質量優先時選 Carbon,預算優先時選 Terra。注意每個數據集只有 10 張圖,單項分數只能當信號,不能當結論。
相關文章
參考來源:本文爲本站原創改寫與整理,事實與數據覈對自 Quantslant 完整官方分數表與 Artificial Analysis 榜單(2026-11-11/12)與 Ultralytics UL37 基準(2026-11-11)
← 返回 Gemini 4 Carbon 專題