腾讯混元 Hy4 专题
腾讯混元 2026 年 11 月 4 日发布的最新一代大模型:770B 总参数 MoE,首次引入视觉理解与电脑操作,1M 上下文。官方称「首次跻身最强开源模型之列」——但正式版权重至今未发布,AA 独立指数 35 分、中国第二,与顶尖闭源仍有明显差距,腾讯自己也承认。本页汇总官方规格、上手路线、价格与中英文首批实测,并明确标注哪些说法尚未证实。
订购 Hy4:中国区域:点击订购 TokenHub 体验 Hy4 · 海外区域:点击订购 TokenHub 体验 Hy4
01关键事实
先把能确认的说清楚:这是个为真实生产力任务打磨的开源阵营旗舰,但「开源」目前还是承诺——能下载的只有 8 月的 preview 权重。
- 发布
- 2026-11-04(腾讯官方新闻稿与混元发布页;Artificial Analysis 页面写 11 月 3 日,是 UTC 日期换算)
- 开发方
- 腾讯混元(Tencent Hunyuan),中国腾讯旗下大模型团队
- 架构
- 稀疏 MoE;770B 总参数,每 token 激活约 49B(腾讯云 techpedia 明确写「Hy4 系列采用 770B 总参数、49B 激活参数」;preview 模型卡:78 层,256 路由专家 + 1 共享专家,top-8 路由)
- 上下文
- 1M tokens(OpenRouter 列 1,048,576);TokenHub 侧约 960K 输入;最大输出 64K(preview 文档口径;OpenRouter 列 65,536)
- 输入 / 输出
- 输入:文本、图像;输出:文本。思考模式默认开启,API 返回 reasoning_content 字段(preview 文档口径)
- 新能力
- 首次引入视觉理解(细粒度图像处理、复杂图表分析、数学视觉推理)与电脑操作(Computer Use,命令行 + 图形界面;Blender、CAD 专项训练)
- 价格
- TokenHub:输入 ¥6 / 输出 ¥18(每百万 tokens),缓存命中 ¥0.3;国际价 $0.834 / $2.501 / $0.042;即日起至 2026-12-31 23:59 北京时间 5 折
- 基准分
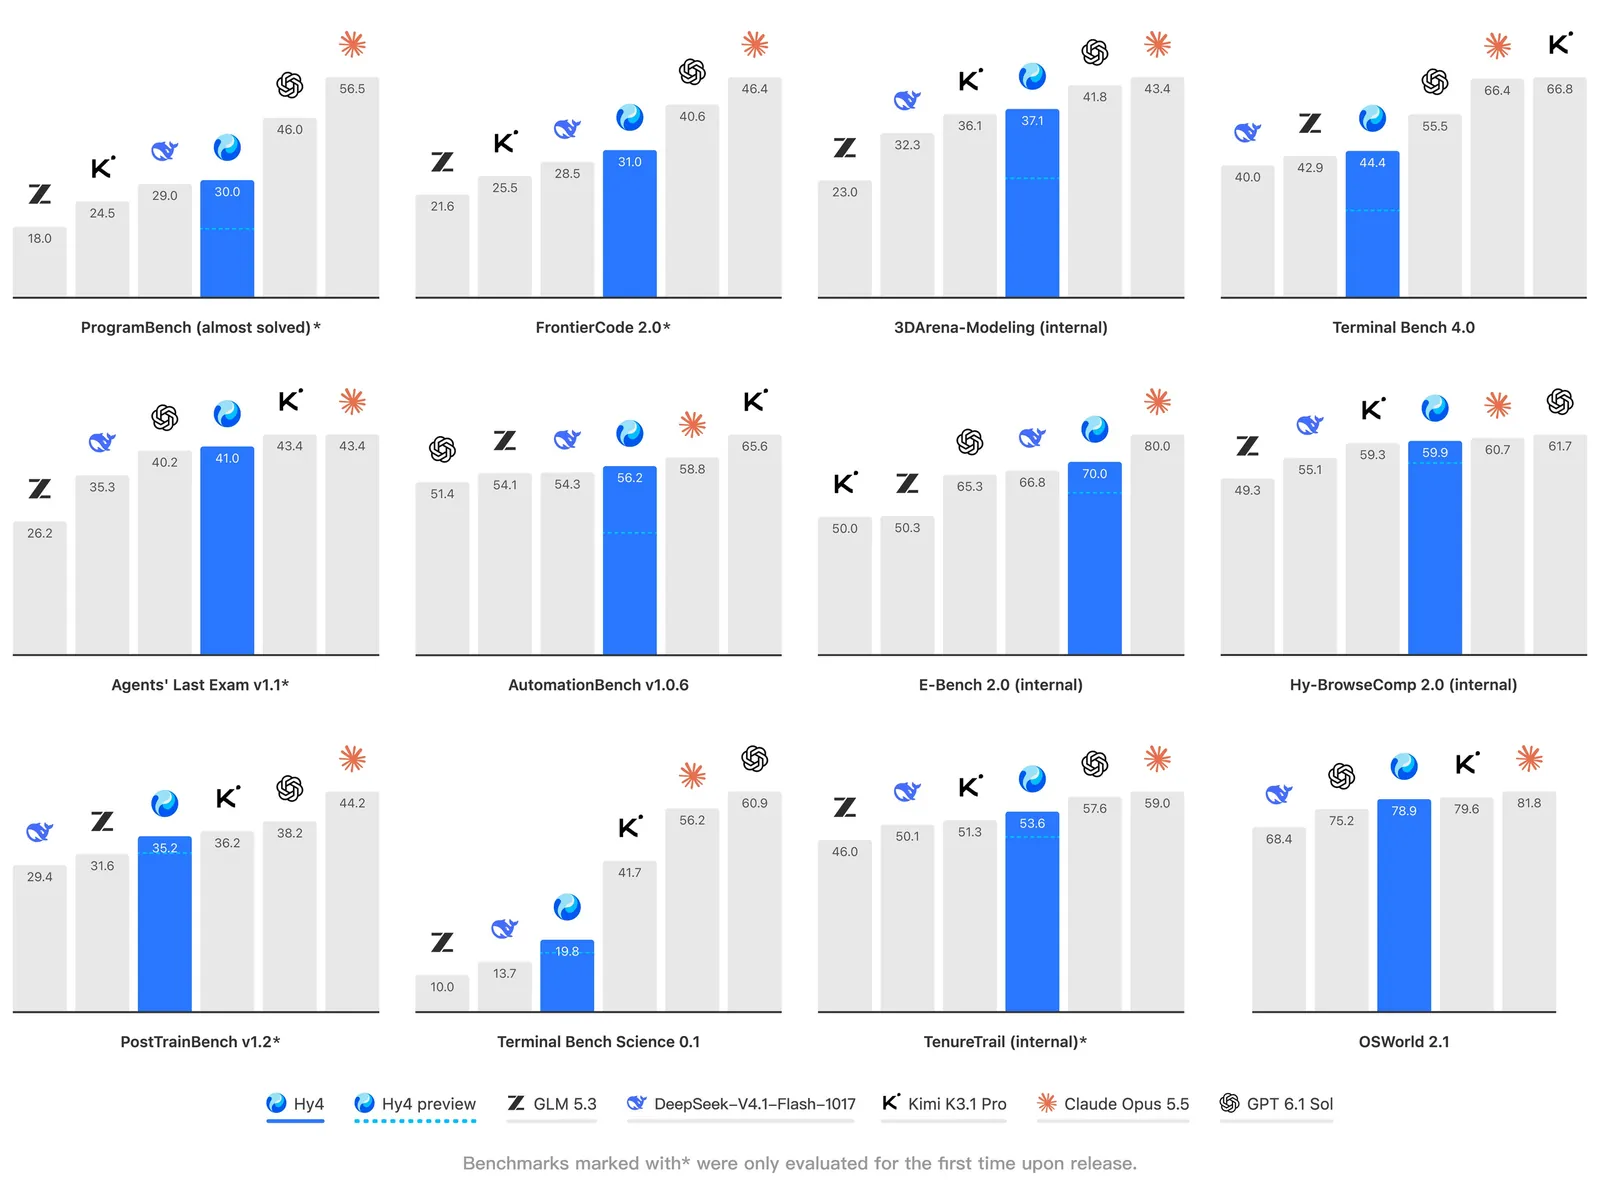
- Artificial Analysis 指数 35(中国第二,仅次于 Kimi K3.1 Pro 的 46);官方 Terminal-Bench 4.0 44.4%(AA 实测 37%);OSWorld 2.1 78.9%;金融众测 3.04 分开源第一
- 权重
- 正式版权重未发布(腾讯称「将于近期开源」,无日期;系统卡片随权重发布);可下载的只有 Hy4 preview(Apache 2.0,BF16 约 1.56TB,FP8 约 814GB)
- 可用渠道
- 腾讯云 TokenHub(模型 ID
hy4)、OpenRouter(tencent/hy4)、Hermes、OpenCode;WorkBuddy/CodeBuddy、元宝、ima、企业微信智能助理大圆 - Hy4 Flash
- 轻量版「近期发布」,继承视觉与 Agent 能力、大幅降低任务成本;无规格、无日期、无价格
- 知识截止
- 未见官方公布
02时间线
从 2 月重建基础设施起,混元平均每两个月推一个大版本;Hy4 从预告到发布只用了 6 天,但权重至今没落地。
- 2026-02
腾讯重建 AI 基础设施;此后混元平均每两个月迭代一个大版本,先以 Preview 开放、再发布正式版。
- 2026-08-28
Hy4 preview 发布并开源:770B 总参数 MoE,纯文本,1M 上下文;权重当日上架 Hugging Face、ModelScope、GitCode、CNB,Apache 2.0,另有 FP8 变体。
- 2026-10-29
腾讯全球数字生态大会预告 Hy4 即将发布:全面提升长程与真实生产力任务能力,首次引入视觉理解;Hy4 Flash 同场预告。会上披露 WorkBuddy 自 3 月上线已处理超 90 亿次任务请求。
- 2026-11-04
Hy4 正式版发布:视觉 + 电脑操作首次加入,预训练与后训练规模显著扩展;定价与 preview 相同,TokenHub 5 折至 12 月 31 日;WorkBuddy/CodeBuddy 免费额度至 11 月 15 日。权重「将于近期开源」,未给日期。
- 2026-11-05
Artificial Analysis 发布独立测量:指数 35 分,中国第二。同日腾讯将 Hy4 推理集群扩容 10 倍——WorkBuddy 用户首日即触发用量限额(Pandaily 报道)。
- 2026-11-06 – 11
极客公园、InfoQ 发布中文实测;多家英文媒体核查权重状态:11 月 11 日复查 Hugging Face 仍只有 preview 权重,
tencent/Hy4返回 401。 - 2026-11-12
人人都是产品经理发布同福客栈场景实测:鹈鹕视频、67 框标注串号、Blender 建模 30 分钟;82 条积分记录显示视频渲染占 98.6%。
- 未来
正式版权重与系统卡「in the coming days」(无日期);Hy4 Flash 近期发布(无规格);下一代 Hy5 规模将进一步扩大(腾讯表态)。
03官方规格
以下为官方已公布口径(腾讯新闻稿、混元发布页、腾讯云文档与 OpenRouter 列表,2026 年 11 月 13 日核查)。注意:11 月 4 日发布原文未重述正式版参数量,770B/49B 来自腾讯云 techpedia 与 preview 模型卡,系统卡待发布后确认。
- 状态
- 已发布(2026-11-04);正式版权重待发布
- 模型 ID
- hy4(TokenHub);tencent/hy4(OpenRouter)
- 架构
- 稀疏 MoE;770B 总参数,每 token 激活约 49B
- 上下文窗口
- 1M tokens(OpenRouter 列 1,048,576);TokenHub 侧约 960K 输入
- 最大输出
- 64K tokens(preview 文档;OpenRouter 列 65,536)
- 输入
- 文本、图像
- 输出
- 文本
- 思考模式
- 默认开启;API 返回 reasoning_content(preview 文档口径)
- API 协议
- 兼容 OpenAI Chat Completions、OpenAI Responses、Anthropic Messages(preview 文档口径)
- 新能力
- 视觉理解;电脑操作(CLI + GUI;Blender、CAD 专项训练)
- 基准分
- AA 指数 35(v5.0.1);Terminal-Bench 4.0 44.4%(官方)
- 权重
- 正式版未发布;preview 可下载(Apache 2.0,BF16 约 1.56TB,FP8 约 814GB)
- 许可
- 正式版许可未公布;preview 为 Apache 2.0
- API 价格
- ¥6 输入 / ¥18 输出(每百万 tokens);5 折至 2026-12-31
04怎么试用:5 条路线
正式版权重没出来之前,所有路线都是托管 API 或腾讯自家产品——没有本地部署这条路。最快的是 WorkBuddy 免费额度与 OpenRouter。
1腾讯云 TokenHub(官方主路线)
腾讯云的模型调用平台,模型 ID hy4(preview 为 hy4-preview)。广州、新加坡目录价相同;即日起至 2026 年 12 月 31 日 23:59 北京时间按目录价 5 折结算。OpenAI 兼容接口,TokenHub 内还可调用第三方模型做对照。
2OpenRouter(海外开发者主路线)
模型 ID tencent/hy4,端点 tencent/hy4-20261104;实时报价 $0.417 / $1.2505(每百万 tokens 输入/输出,标注 5 折),缓存读取 $0.021。上下文 1,048,576 tokens,最大输出 65,536 tokens,支持 reasoning、tools/tool_choice 与 JSON schema 结构化输出。P50 吞吐约 63 tok/s,P50 首 token 约 2.9 秒。
3WorkBuddy / CodeBuddy(免费额度)
腾讯的 Agent 办公产品,Hy4 已内置。11 月 4–15 日提供一定额度的免费使用(后延至 11 月 15 日 23:59);11 月 5 日首日用户即触发限额,腾讯将推理集群扩容 10 倍并提高免费额度,繁忙时段仍可能限额,官方建议限额时切换 Hy3。适合零代码试用长程 Agent、文档双写与办公协作。
4元宝、ima、企业微信智能助理大圆
腾讯自家消费与办公产品均已接入 Hy4,无需开发,直接在产品内使用。QQ、王者荣耀、和平精英、微信读书、腾讯新闻等产品持续接入中。
5第三方平台 API:Hermes、OpenCode
API 已同步接入 Hermes 与 OpenCode 等平台,适合编码 Agent 场景。另有目录站称 Novita AI 亦有 $0.42 / $1.25 报价(11 月 12 日核查,未经本站验证)。
05价格解析
目录价与 preview 完全相同,加量不加价;5 折只到 12 月 31 日,期满恢复目录价。价格为 2026 年 11 月 10–13 日核查口径,结账页价格为准。
| 项目(每百万 tokens) | 目录价 | 5 折价(至 2026-12-31) |
|---|---|---|
| TokenHub 输入(广州 / 新加坡) | ¥6.00 | ¥3.00 |
| TokenHub 输出 | ¥18.00 | ¥9.00 |
| TokenHub 缓存命中输入 | ¥0.30 | ¥0.15 |
| 国际价 输入 | $0.834 | $0.417 |
| 国际价 输出 | $2.501 | $1.2505 |
| 国际价 缓存读取 | $0.042 | $0.021 |
| OpenRouter(输入 / 输出 / 缓存读取) | $0.834 / $2.501 / $0.042 | $0.417 / $1.2505 / $0.021 |
| WorkBuddy / CodeBuddy 免费额度 | 11 月 4–15 日一定额度 | — |
任务成本:AA 测得每任务约 $0.78
Artificial Analysis 的独立测量给出每指数任务约 $0.78,约为同分 Grok 4.7(xhigh)的 1/10、Qwen3.8 Max 的 1/13(腾讯引用的 AA 对比口径)。便宜的原因不在单价——$0.834/$2.501 的目录价在同档里只是中游——而在任务结构;但另一面是输出量:AA 评测中 Hy4 生成 1.6 亿输出 tokens,约为中位数的两倍,啰嗦会吃掉一部分价格优势。OpenRouter 上的缓存命中率约 93%,长上下文、重复前缀多的任务实际账单可能低于目录价。
官方页面:腾讯官方新闻稿 · 混元 Hy4 发布页 · 腾讯云 Hy4 介绍
订购 Hy4:中国区域:点击订购 TokenHub 体验 Hy4 · 海外区域:点击订购 TokenHub 体验 Hy4
06首批实测与测评
以下全部是 11 月 4–13 日的首批上手实测与分析:样本小、方法不一,请按「个案」看待。每条都给出结论徽章;点「阅读本站全文」进入本站的深度改写文章页,文末附原始出处。
中文来源
极客公园实测:CPO 研报、3D 腕表与游戏复刻
结论:开源第一梯队门槛,全球顶尖仍在追赶来源:极客公园,2026-11-04 之后(长程 Agent、多模态与视觉代码三线实测)
CPO 赛道投研任务交付了报告 PDF + 可复算估值模型,评价为「初级研究助理」雏形;Three.js 3D 机械腕表拆解网页交互全跑通;NAIAD 游戏复刻走完「多帧看懂 → 重做一遍 → 渲染回读验证」闭环。结论:视觉让产品更好用,但还定不了胜负;真正的考验要看 Hy5。
阅读本站全文 → (本站原创整理)
同福客栈打工实测:鹈鹕视频、67 框标注与 Blender 建模
结论:眼睛和手能干活,空间一致性与表格汇总还得人验收来源:人人都是产品经理(数智奔流),2026-11-12(WorkBuddy 实测:视频生成、视觉标注、Blender 建模)
鹈鹕骑车视频 13 分钟出第一版,气氛足但客栈布局大变样、后门没出现;大堂找茬交出 67 个编号框与 15 类检视表,但 52/53 号与表格串号;Blender 建模 30 分钟,木梁回廊花格窗都有,转折楼梯变直跑、纹样重复。82 条积分记录共 3429.15 积分,视频渲染占 98.6%。
阅读本站全文 → (本站原创整理)
InfoQ 实测:55 分钟做三轮塔防游戏
结论:任务闭环能力是真变化,细节仍需人验收来源:InfoQ,2026-11-04 之后(WorkBuddy 实测:游戏研发、视觉推理、商业策划、创意设计)
从零做塔防游戏三轮迭代共 55 分钟(14分10秒 / 18分钟 / 23分18秒),从工程搭建到部署上线全程自动化模拟与 Chrome 回归测试;双机器人协同调度四项全通过且证明了最优性;业务单据核对识别准确,但出现计数表述错误与无依据推断;商业计划 PPT 比 Hy3 更有商业判断,海报创意更好但呈现不够精准。
财新:腾讯坦承与顶尖闭源仍有较大差距
结论:发布口径里少见的坦诚来源:财新网,2026-11-04
混元团队自称「Hy4 是目前最强的开源模型之一」,但也承认与顶尖闭源模型仍然存在较大差距,「将持续稳健地扩展预训练和后训练规模,努力缩小差距」。自 2 月重建基础设施以来平均每两个月迭代一个大版本,下一个版本 Hy5 的规模还将进一步扩大。
英文来源
madrobot:会用电脑,但仍落后 Claude
结论:官方图表自己暴露了差距来源:madrobot.blog,2026-11-04
腾讯发布帖罕见地专设一节讲局限:前沿数学、长程开发、模型迭代与视觉问答上与顶尖闭源「仍有较大差距」。官方图表佐证:Terminal-Bench 4.0 上 Hy4 44.4%,Claude Opus 5.5 66.4%、GPT-6.1 Sol 55.5%;最接近的是 OSWorld 2.1(78.9% 对 Claude 81.8%)。权重未出、许可未定。
Artificial Analysis 独立测量:35 分,中国第二
结论:性价比突出,幻觉率是硬伤来源:Artificial Analysis,2026-11-05(指数 v5.0.1)
AA 指数 35 分,与 Grok 4.7(xhigh)持平,中国实验室第二(Kimi K3.1 Pro 46 分第一);每任务约 $0.78,约同分 Grok 的 1/10。但 AA-Omniscience 幻觉率 89%(Kimi 37%),AA 实测 Terminal-Bench 4.0 仅 37%(官方 44.4%),且「慢于平均、非常啰嗦」。
阅读本站全文 → (本站原创整理)
apiyi:12 项基准里无一项第一
结论:别被「最强开源」四个字带偏来源:apiyi,2026-11-04(官方 12 项主图表逐项排名)
逐项统计官方主图表:Hy4 在 12 项中无一项第一,最好成绩是 E-Bench 2.0 第二;与 Kimi K3.1 Pro 在开源阵营 6:6 打平;附录里差距更大——Hy-FrontierMath T5 仅 13.0 分,对 GPT-6.1 Sol 的 97.5。提醒:全部是腾讯自测,对手分数是腾讯同场重跑,不是各家公布值。
阅读本站全文 → (本站原创整理)
权重状态核查:承诺,不是现状
结论:能下载的只有 preview来源:digitalapplied、orcarouter、EveryInfra,2026-11-05/07/11
三家独立核查结论一致:11 月 11 日复查 Hugging Face 仍只有 Hy4 preview 权重;tencent/Hy4 返回 401,GitHub 无 Hy4 仓库;正式版参数量、许可协议、模型卡均未公布。orcarouter 的判语是「版本号上去了,开源程度下来了」——preview 是发布当天即开源,正式版反过来先 API、权重随后。
阅读本站全文 → (本站原创整理)
06B文章目录:本站深度解读
以下 7 篇均为本站原创改写与再整理的深度文章——重新组织结构、补充结论与选型建议,事实与数据与原始测评核对一致。点击任意一篇在本站内阅读,文末附原始出处。
06C基准测试:官方表 + 独立榜单
官方给了 34 项附录与 12 项主图表,数据很全;但全部是厂商自测,对手分数是腾讯同场重跑而非各家公布值。读分数前先看条件,再看独立测量怎么说。
| 测试(官方附录,厂商自测) | Hy4 | Hy4 preview | 对照 |
|---|---|---|---|
| DeepSWE v1.1 | 74.9 | 64.3 | — |
| APEX-Agents v1.1 (pass@1) | 75.2 | 53.9 | — |
| OSWorld 2.1(partial score) | 78.9 | — | Claude Opus 5.5 81.8;Kimi K3.1 Pro 79.6;GPT-6.1 Sol 75.2 |
| MMMU-Pro | 78.6 | — | — |
| AutomationBench v1.0.6 | 56.2 | 36.3 | Kimi K3.1 Pro 65.6;Claude Opus 5.5 58.8 |
| Terminal-Bench 4.0 | 44.4 | 26.3 | Kimi K3.1 Pro 66.8;Claude Opus 5.5 66.4;GPT-6.1 Sol 55.5 |
| SWE-Marathon v1.1 | 43.8 | 31.9 | 时限翻倍口径 |
| Agents' Last Exam v1.1 | 41.0 | — | Kimi / Claude 43.4 |
| FrontierCode 2.0 | 31.0 | — | Claude Opus 5.5 46.4;GPT-6.1 Sol 40.6 |
| ProgramBench (almost solved) | 30.0 | 17.5 | Claude Opus 5.5 56.5;GPT-6.1 Sol 46.0 |
| HLE-Full (with tools) | 59.1 | 57.3 | — |
| Terminal-Bench-Science 0.1 | 19.8 | 16.2 | GPT-6.1 Sol 60.9;Claude Opus 5.5 56.2 |
| Hy-FrontierMath T5(内部) | 13.0 | 7.8 | GPT-6.1 Sol 97.5;Claude Opus 5.5 91.3 |
| Goal2Repo(内部) | 23.2 | 18.1 | Claude Opus 5.5 74.0 |
| BuddyVQA Atlas(无工具,内部) | 55.6 | — | Claude Opus 5.5 75.3 |
独立榜单与第三方测量
| 测量 | 来源 | Hy4 成绩 | 对照 |
|---|---|---|---|
| AA 智能指数 v5.0.1 | Artificial Analysis,11 月 5 日 | 35,中国第二 | Kimi K3.1 Pro 46;Grok 4.7(xhigh)35;Haiku 5.5(max)36;Qwen3.8 Max 45 |
| AA Terminal-Bench 4.0 | Artificial Analysis(自有 harness) | 37% | 官方 44.4%(Claude Code harness)——口径不同 |
| AA FrontierCode 2.0 | Artificial Analysis | 31% | 中国实验室第一;DeepSeek V4.1 Flash 28%;Kimi 25% |
| AA-Omniscience v1.1 | Artificial Analysis | 准确率 50%,幻觉率 89% | Kimi K3.1 Pro 幻觉率 37%;准确率与幻觉率是两个独立指标 |
| AA HLE-Diamond | Artificial Analysis | 33% | — |
| AA 每任务成本 | Artificial Analysis | 约 $0.78 / 任务 | 约同分 Grok 4.7 的 1/10 |
| AA 输出 token 量 | Artificial Analysis | 评测中 1.6 亿 | 中位约 7280 万(约 2 倍),「非常啰嗦」 |
| Agent Arena | Agent Arena(排名 preliminary) | 第 13 名 | 腾讯称开源模型中第一 |
| 金融众测(579 任务,4 分制) | 腾讯 FiT 组织,213 位专家 | 3.04,开源第一 | DeepSeek-V4.1-Flash-1017 2.97;Kimi / GLM 5.3 均为 2.68 |
完整盘点见本站基准测试专文 →
07对比
vs Hy4 preview(前代)
| 维度 | Hy4 | Hy4 preview |
|---|---|---|
| 发布 | 2026-11-04 | 2026-08-28 |
| 参数 | 770B 总 / 49B 激活(腾讯云口径) | 770B 总 / 49B 激活(模型卡) |
| 视觉理解 | 有(首次引入) | 无(纯文本) |
| 电脑操作 | 有(首次支持) | 无 |
| 权重 | 未发布 | Apache 2.0,已发布 |
| Terminal-Bench 4.0 | 44.4 | 26.3 |
| DeepSWE v1.1 | 74.9 | 64.3 |
| APEX-Agents v1.1 | 75.2 | 53.9 |
| 幻觉率(内部通用测试) | 7.2% | 12.95% |
| 价格 | ¥6 / ¥18(相同) | ¥6 / ¥18 |
正式版全面强于 preview,但「开源」上反过来了:preview 发布当天即开源,正式版至今只有承诺。想本地跑,只能用没有视觉与电脑操作的 preview。
vs 开源对手(2026-11-13 口径)
| 模型 | AA 指数 | Terminal-Bench 4.0 | API 价格 $/百万(入/出) | 权重 |
|---|---|---|---|---|
| 腾讯 Hy4 | 35 | 44.4%(官方)/ 37%(AA) | 0.83 / 2.50(5 折:0.42 / 1.25) | 待发布 |
| Kimi K3.1 Pro | 46 | 66.8%(腾讯表内) | — | 已发布(11 月 4 日) |
| DeepSeek V4.1 Flash | 32.6 | 33.8%(AA 口径)/ 40.0%(腾讯表内) | — | 开源权重 |
| GLM-5.3 | — | 41.9%(AA 口径)/ 42.9%(腾讯表内) | — | 开源权重 |
| Inkling 2 Small | 31 | 13.1% | 0.30 / 1.00 | Apache 2.0,已发布 |
| GLM-5.3-Flash | 27.8 | 32.8% | — | 开源权重 |
与闭源旗舰的差距:腾讯自己画的线
官方图表里,Hy4 与 Claude Opus 5.5、GPT-6.1 Sol 的差距在最难的测试上最大:Hy-FrontierMath T5 仅 13.0 分(GPT 97.5、Claude 91.3),Goal2Repo 23.2(Claude 74.0),Terminal-Bench-Science 19.8(GPT 60.9)。最接近的是电脑操作类:OSWorld 2.1 78.9%,距 Claude 的 81.8% 只差 2.9 分,且领先 GPT 的 75.2%。腾讯在发布页专设一节承认:在前沿数学、长程开发、模型迭代与视觉问答高难测试上「仍有较大差距」。
08还缺什么(截至 11 月 13 日)
- 正式版权重与系统卡(腾讯称「in the coming days」,无日期;11 月 11 日复查仍未发布)
- 正式版许可协议(preview 是 Apache 2.0,正式版未公布)
- 正式版参数量与分层架构的官方确认(发布原文未重述,系统卡待发布)
- Hy4 Flash 的规格、日期与价格(仅知「近期发布」)
- 知识截止日期(未见官方公布)
- 权重发布后的独立本地运行实测与跑分复现(尚无)
- AA-Omniscience 幻觉率 89% 的进一步分析(AA 未给解释;与腾讯内部 7.2% 的口径差异待厘清)
- TokenHub 国际区与国内区的详细可用性差异
- 英文独立深度实测(目前英文以分析文章为主,无独立跑分复现)
09谣言核查
Hy4 的混淆主要来自 preview 与正式版的错位——不少报道把 preview 的权重、参数与许可直接安到正式版头上,逐条澄清如下。
不成立 「Hy4 已经开源了」
正式版权重截至 11 月 13 日未发布:11 月 5 日核查 tencent/Hy4 返回 401,GitHub 无 Hy4 仓库;11 月 11 日复查 Hugging Face 仍只有 preview 权重。能下载的只有 8 月 28 日的 Hy4 preview(Apache 2.0)。多家聚合(byteiota、verticaltabs)把 preview 权重写成正式版权重,是混淆。
不成立 「Terminal-Bench 4.0 是 39.39%」
39.39% 出现在部分聚合的基准列表里,但其基准归属与测试 harness 不明;官方 TB 4.0 是 44.4%(Claude Code harness),AA 独立实测是 37%。39.39% 不能作为 TB 4.0 的分数引用——本站 Inkling 专题页此前引用的 39.39% 亦需修正。
部分成立 「770B 参数是正式版官方公布的」
11 月 4 日发布原文未重述正式版参数量与分层架构;770B/49B 来自腾讯云 techpedia(写「Hy4 系列」)与 preview 模型卡。数字本身可信度较高,但严格说要等系统卡确认;正式版的许可协议同样未公布。
部分成立 「Hy4 是最强开源模型」
只在特定口径下成立:金融众测开源第一(腾讯组织)、Agent Arena 开源第一(排名 preliminary)。但官方 12 项主图表里 Hy4 无一项第一,AA 指数中国第二(Kimi K3.1 Pro 46 分在前),与闭源旗舰差距明显。「最强」要看比什么、谁组织的测试。
部分成立 「Hy4 幻觉率只有 7.2%」
7.2% 是腾讯内部通用测试的结果(preview 为 12.95%);搜索专项优化后的自建测试是 5.45%(preview 15.76%)。但 AA-Omniscience 独立测量给出 89% 幻觉率——不同测试、不同口径,测的不是同一种「幻觉」。内部数字与独立数字都要看,不能只挑好看的。
已澄清 「到底是 11 月 3 日还是 11 月 4 日发布?」
官方北京时间 11 月 4 日;Artificial Analysis 页面写 11 月 3 日,是 UTC 日期换算。另有中文聚合写 10 月 29 日,那是大会预告日,不是发布日。
10FAQ
Hy4 什么时候发布的?
2026 年 11 月 4 日正式发布(腾讯官方新闻稿与混元发布页,北京时间;AA 页面写 11 月 3 日是 UTC 日期)。前代 Hy4 preview 于 2026 年 8 月 28 日发布并开源。时间线见本页第 02 节。
Hy4 的权重在哪里下载?
正式版权重截至 11 月 13 日未发布,无法下载。能下载的只有 Hy4 preview:Hugging Face 仓库 tencent/Hy4-preview(另有 FP8 变体),Apache 2.0 许可,BF16 约 1.56TB、FP8 约 814GB;ModelScope、GitCode、CNB 亦有。注意 preview 是纯文本模型,没有视觉与电脑操作。详见本站权重状态专文。
Hy4 是开源的吗?
现状是「承诺开源」:腾讯称正式版权重「将于近期开源」并随附系统卡,但截至 11 月 13 日未落地、无日期,正式版许可协议也未公布。已开源的是 8 月的 preview(Apache 2.0)。目前正式版只能通过腾讯云 TokenHub、OpenRouter 与腾讯自家产品以 API 方式使用。
Hy4 价格是多少?
TokenHub 目录价:输入 ¥6 / 输出 ¥18 / 缓存命中 ¥0.3(每百万 tokens),与 preview 相同;国际价 $0.834 / $2.501 / $0.042。即日起至 2026 年 12 月 31 日 23:59 北京时间按目录价 5 折结算(¥3/¥9/¥0.15;OpenRouter $0.417/$1.2505/$0.021),期满恢复目录价。详见本站价格指南。
Hy4 怎么用?有哪些渠道?
API:腾讯云 TokenHub(模型 ID hy4)、OpenRouter(tencent/hy4)、Hermes、OpenCode。产品内直接用:WorkBuddy/CodeBuddy(11 月 4–15 日有免费额度)、元宝、ima、企业微信智能助理大圆。QQ、王者荣耀、微信读书等腾讯系产品持续接入中。本地部署目前只能用 preview 权重。
Hy4 的 AA 指数 35 分是什么水平?
Artificial Analysis 智能指数 v5.0.1 为 35 分,与 Grok 4.7(xhigh)持平,落后 Claude Haiku 5.5(max,36)1 分;中国实验室中第二,仅次于 Kimi K3.1 Pro(46),领先 Qwen3.8 Max(45)与 DeepSeek V4.1 Flash(32.6)。AA 原话是同价位中低于平均(中位 41)。
Hy4 的 Terminal-Bench 4.0 到底是 44.4% 还是 37%?
两个数都对,但测试条件不同:44.4% 是腾讯官方附录(Claude Code harness,最多 500 轮、每任务最多 13 小时);37% 是 Artificial Analysis 独立实测(AA 自有 harness)。不要混用。另有聚合流传的 39.39% 来源不明,本页不采纳。
Hy4 和 Hy4 preview 有什么区别?
正式版在预训练与后训练规模上显著扩展,首次加入视觉理解与电脑操作,指令遵循、长文理解、长程 Agent 全面提升;Terminal-Bench 4.0 从 26.3 升至 44.4,DeepSWE 从 64.3 升至 74.9。价格相同。但 preview 发布当天即开源,正式版权重至今未发布——这是两者最大的反差。
Hy4 和 Kimi K3.1 Pro 比怎么样?
官方 12 项主图表里两者 6:6 打平:Hy4 在代码生成、3D 建模、检索与科研任务占优;Kimi 在终端操作、自动化与科学终端任务领先,Terminal-Bench 4.0 达 66.8%(Hy4 44.4%)。AA 指数 Kimi 46 分高于 Hy4 的 35 分;金融众测 Hy4 3.04 分高于 Kimi 的 2.68。详见本站开源对手对比。
Hy4 支持视觉和电脑操作吗?
支持,都是 Hy 系列首次。视觉:细粒度图像处理、复杂图表分析、数学视觉推理(官方演示:28 亿像素航拍图定位约 2 米屋顶构件)。电脑操作:命令行 + 图形界面结合,Blender、CAD 等专业软件专项训练;OSWorld 2.1 得 78.9%,距 Claude Opus 5.5 的 81.8% 只差 2.9 分。
Hy4 Flash 是什么?什么时候发布?
Hy4 的轻量版,继承视觉与 Agent 能力、大幅降低任务成本,主打极致性价比。腾讯只说「近期发布」,无规格、无日期、无价格——不能把它当作当前 Hy4 的速度档位。
Hy4 的上下文窗口多大?
1M tokens(OpenRouter 列 1,048,576);TokenHub 侧约 960K 输入。最大输出 64K tokens(preview 文档口径;OpenRouter 列 65,536)。
11来源
本页事实均来自以下公开来源(核查于 2026 年 11 月 13 日)。
官方
- 腾讯 — 腾讯混元发布 Hy4,跻身最强开源模型之列(官方新闻稿,含 12 项基准图) 11 月 4 日
- 腾讯混元 — Hy4 正式发布(官方发布页,含 34 项基准附录) 11 月 4 日
- 腾讯云开发者社区 — 混元 Hy4 简介:优势与应用场景
- Artificial Analysis — Tencent Hy4 模型页(指数 35) 11 月 5 日
- DataLearner — Tencent Hy4:评测、价格、API 与模型参数(34 项附录转载) 11 月 10 日更新
英文报道与分析
- madrobot — Tencent Hy4 is out: it can use a computer but still trails Claude 11 月 4 日
- apiyi — How Powerful Is Hy4?(12 项基准逐项排名分析) 11 月 4 日
- digitalapplied — Tencent Hy4 Is Out: What Is Confirmed and What Is Not Yet 11 月 4 日
- OrcaRouter — Tencent Hy4 vs Hy4 Preview: Newer Model, Less Open 11 月 7 日
- CellCog — Tencent Hy4: Out of Preview, Now With Vision
- dev.to — Tencent's Hy4 Can See and Use Your Computer — Explained Honestly
- AI Affairs — Tencent expands Hy4 inference capacity tenfold after WorkBuddy users hit quotas 11 月 5 日
- AICoder — Artificial Analysis: Tencent Hy4 Scores 35 on Intelligence Index v5 11 月 5 日
- EveryInfra — Tencent Hy4 function calling(11 月 11 日 HF 权重复查)
- AlphaSignal — Tencent's Hy4 Brings 1M Context and Agent Tools at a Tenth the Cost 11 月 5 日
- TeamoRouter — Tencent Hy4 API: Price, Specs and How to Call