Hy4 基准测试全盘点:官方 34 项、AA 35 分与口径里的坑
Hy4 的基准数据分两批:一批是腾讯官方给的——12 项主图表加 34 项附录,数据很全;另一批是 Artificial Analysis 在 11 月 5 日给出的独立测量,指数 35 分。两批数据都可信,但口径不同,混用会得出错误结论。本文把全部可核查的分数列出来,并把口径陷阱逐个标清。
官方 12 项主图表:无一项第一
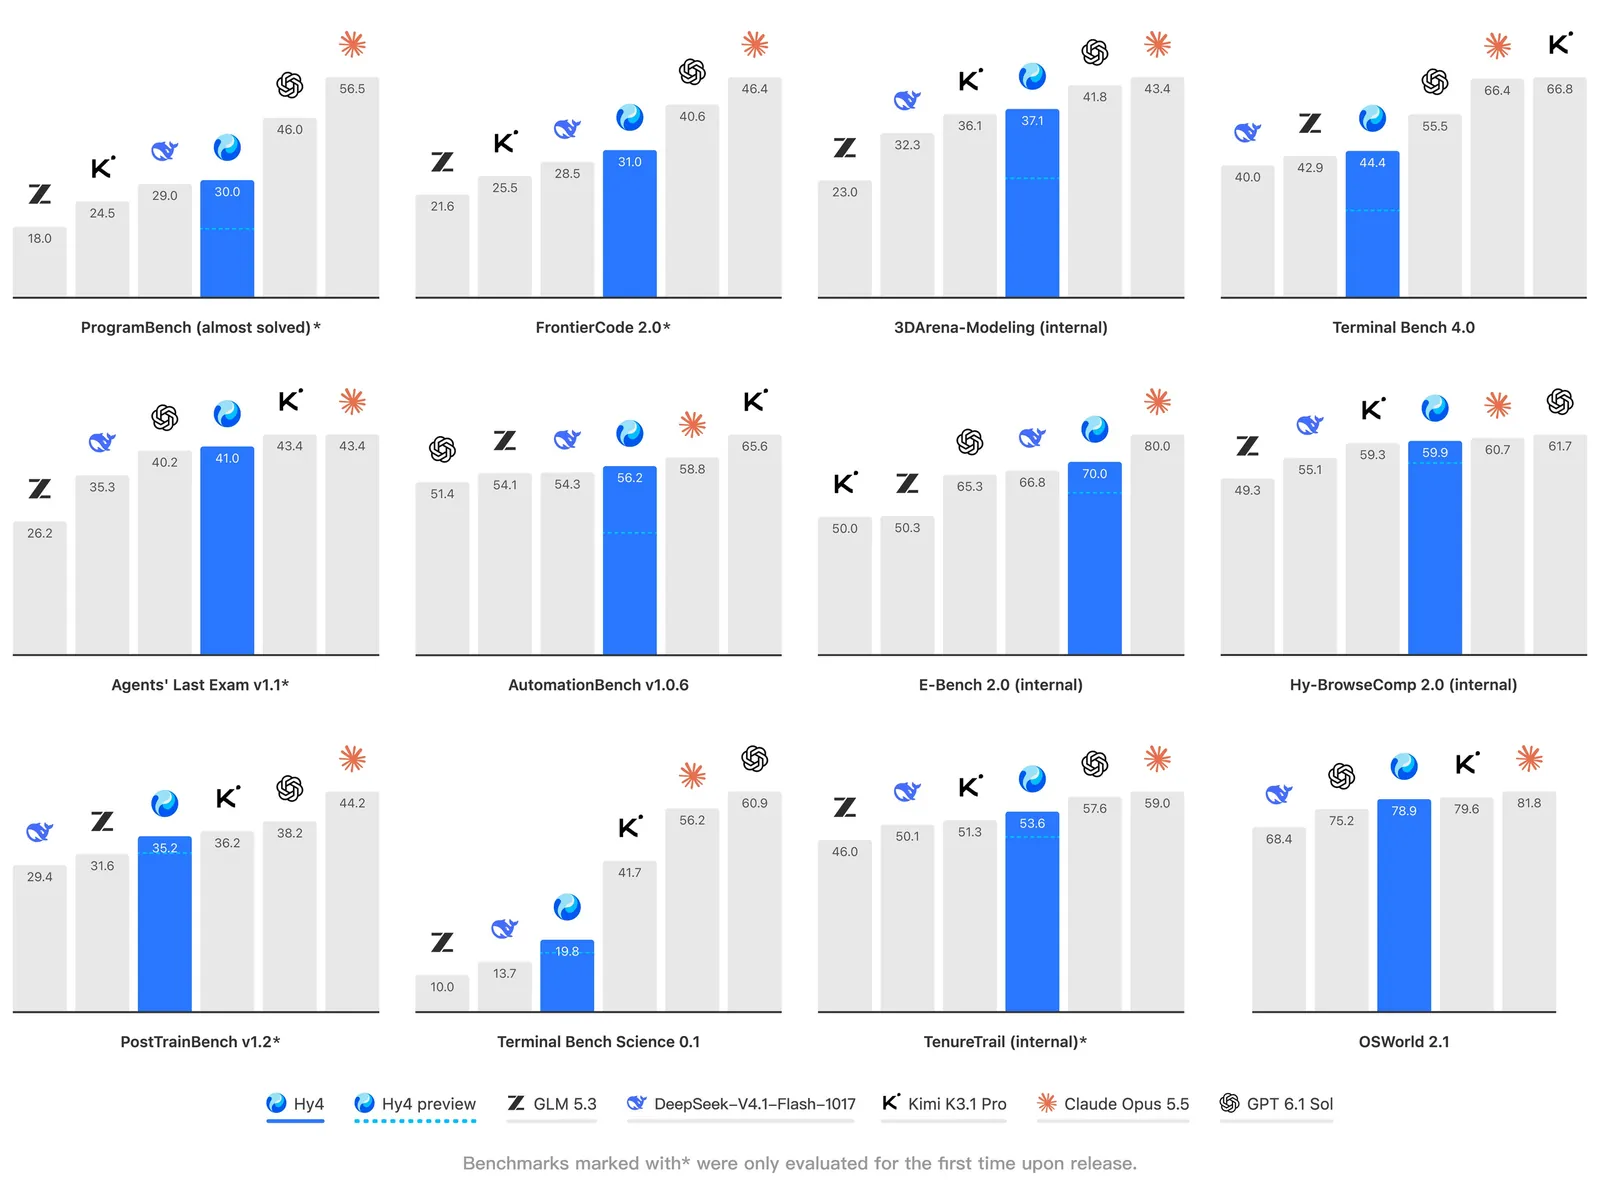
腾讯新闻稿的主图把 Hy4 与 Hy4 preview、GLM 5.3、DeepSeek-V4.1-Flash-1017、Kimi K3.1 Pro、Claude Opus 5.5、GPT-6.1 Sol 同场对比。apiyi 逐项统计的结果是:Hy4 在 12 项中无一项第一,最好成绩是 E-Bench 2.0 的第二名(70.0)。与 Kimi K3.1 Pro 在开源阵营里 6:6 打平——Hy4 在代码生成、3D 建模、检索与科研任务占优,Kimi 在终端操作、自动化与科学终端任务领先。
最接近闭源旗舰的是 OSWorld 2.1:78.9%,距 Claude Opus 5.5 的 81.8% 只差 2.9 分,且领先 GPT-6.1 Sol 的 75.2%。差距最大的是 Terminal-Bench 4.0:Kimi 66.8、Claude 66.4、GPT 55.5,Hy4 只有 44.4;ProgramBench 上 Claude 56.5,Hy4 30.0。
官方 34 项附录:强项与短板都很清楚
发布页附录列出约 34 项测试(DataLearner 完整转载),全部在当时最高推理档下测得。强项集中在 Agent 与电脑操作:DeepSWE v1.1 74.9(preview 64.3)、APEX-Agents v1.1 75.2(preview 53.9)、OSWorld 2.1 78.9、MMMU-Pro 78.6、AutomationBench v1.0.6 56.2(preview 36.3)、HLE-Full(带工具)59.1。
短板同样清楚,而且腾讯没有藏:Hy-FrontierMath T5(内部数学测试)仅 13.0,GPT-6.1 Sol 是 97.5、Claude 91.3;Goal2Repo 23.2,Claude 74.0;Terminal-Bench-Science 19.8,GPT 60.9;BuddyVQA Atlas(无工具)55.6,Claude 75.3。SWE-Marathon v1.1 43.8 是在时限翻倍口径下测的,读的时候要注意条件。另有 ZeroBench-main 55.4、PostTrainBench 35.2、TenureTrail 53.6 等约 15 项内部评估,外部无法复现,只能当作腾讯自述。
独立测量:AA 指数 35,中国第二
Artificial Analysis 在 11 月 5 日发布独立测量:智能指数 v5.0.1 为 35 分,与 Grok 4.7(xhigh)持平,落后 Claude Haiku 5.5(max,36)1 分;中国实验室中第二,仅次于 Kimi K3.1 Pro(46),领先 Qwen3.8 Max(45)与 DeepSeek V4.1 Flash(32.6)。AA 原话是同价位中低于平均(中位 41)。
AA 的分项测量值得细读。FrontierCode 2.0 得 31%,是中国实验室第一(DeepSeek 28%、Kimi 25%)。HLE-Diamond 33%。每任务成本约 $0.78,约为同分 Grok 的 1/10。但 AA-Omniscience v1.1 给出准确率 50%、幻觉率 89%——Kimi 的幻觉率是 37%。注意准确率与幻觉率是两个独立指标,不要把 89% 理解成「89% 的回答是错的」;AA 也未给出解释。Agent Arena 上 Hy4 暂列第 13 名(排名 preliminary),腾讯称开源模型中第一。
AA 还记录了两个工程特征:Hy4「慢于平均、非常啰嗦」——评测中生成 1.6 亿输出 tokens,约为中位数的两倍;OpenRouter 上 P50 吞吐约 63 tok/s,P50 首 token 约 2.9 秒。便宜的任务成本有一部分会被啰嗦的输出吃掉。
口径陷阱:44.4% 与 37% 都是对的
Terminal-Bench 4.0 有两个数,不要混用:官方 44.4%(Claude Code harness,最多 500 轮、每任务最多 13 小时)与 AA 实测 37%(AA 自有 harness)。两者测试条件不同,都对,但不是同一个测试。同样,Kimi K3.1 Pro 的 TB 4.0 在腾讯表内是 66.8%,在另一口径下是 65.7%——引用时要注明来源。
还有一个数字要特别提醒:部分聚合里流传的 39.39%,其基准归属与测试 harness 不明,本页不采纳为 TB 4.0 的分数。本站 Inkling 专题页此前引用的 39.39% 亦需修正。
金融与办公:腾讯组织的评估
FiT 金融众测由腾讯组织,213 位专家(153 位外部)、579 项任务、4 分制:Hy4 3.04 分,开源第一,DeepSeek-V4.1-Flash-1017 2.97,Kimi 与 GLM 5.3 均为 2.68。IRAB 评估(讯兔科技)显示相对 preview 提升 12.03 分。WorkBuddy 办公室评估平均 83.18 分、通过率 96.15%,12 个场景里 9 个中国第一。这些评估的组织方或数据源与腾讯有关,读数时要打这个折扣。
参考来源:DataLearner — Tencent Hy4:评测、价格、API 与模型参数(本文为本站改写与整理,事实以官方来源与 Artificial Analysis 为准)