Hy4 基準測試全盤點:官方 34 項、AA 35 分與口徑裏的坑
Hy4 的基準數據分兩批:一批是騰訊官方給的——12 項主圖表加 34 項附錄,數據很全;另一批是 Artificial Analysis 在 11 月 5 日給出的獨立測量,指數 35 分。兩批數據都可信,但口徑不同,混用會得出錯誤結論。本文把全部可覈查的分數列出來,並把口徑陷阱逐個標清。
官方 12 項主圖表:無一項第一
騰訊新聞稿的主圖把 Hy4 與 Hy4 preview、GLM 5.3、DeepSeek-V4.1-Flash-1017、Kimi K3.1 Pro、Claude Opus 5.5、GPT-6.1 Sol 同場對比。apiyi 逐項統計的結果是:Hy4 在 12 項中無一項第一,最好成績是 E-Bench 2.0 的第二名(70.0)。與 Kimi K3.1 Pro 在開源陣營裏 6:6 打平——Hy4 在代碼生成、3D 建模、檢索與科研任務佔優,Kimi 在終端操作、自動化與科學終端任務領先。
最接近閉源旗艦的是 OSWorld 2.1:78.9%,距 Claude Opus 5.5 的 81.8% 只差 2.9 分,且領先 GPT-6.1 Sol 的 75.2%。差距最大的是 Terminal-Bench 4.0:Kimi 66.8、Claude 66.4、GPT 55.5,Hy4 只有 44.4;ProgramBench 上 Claude 56.5,Hy4 30.0。
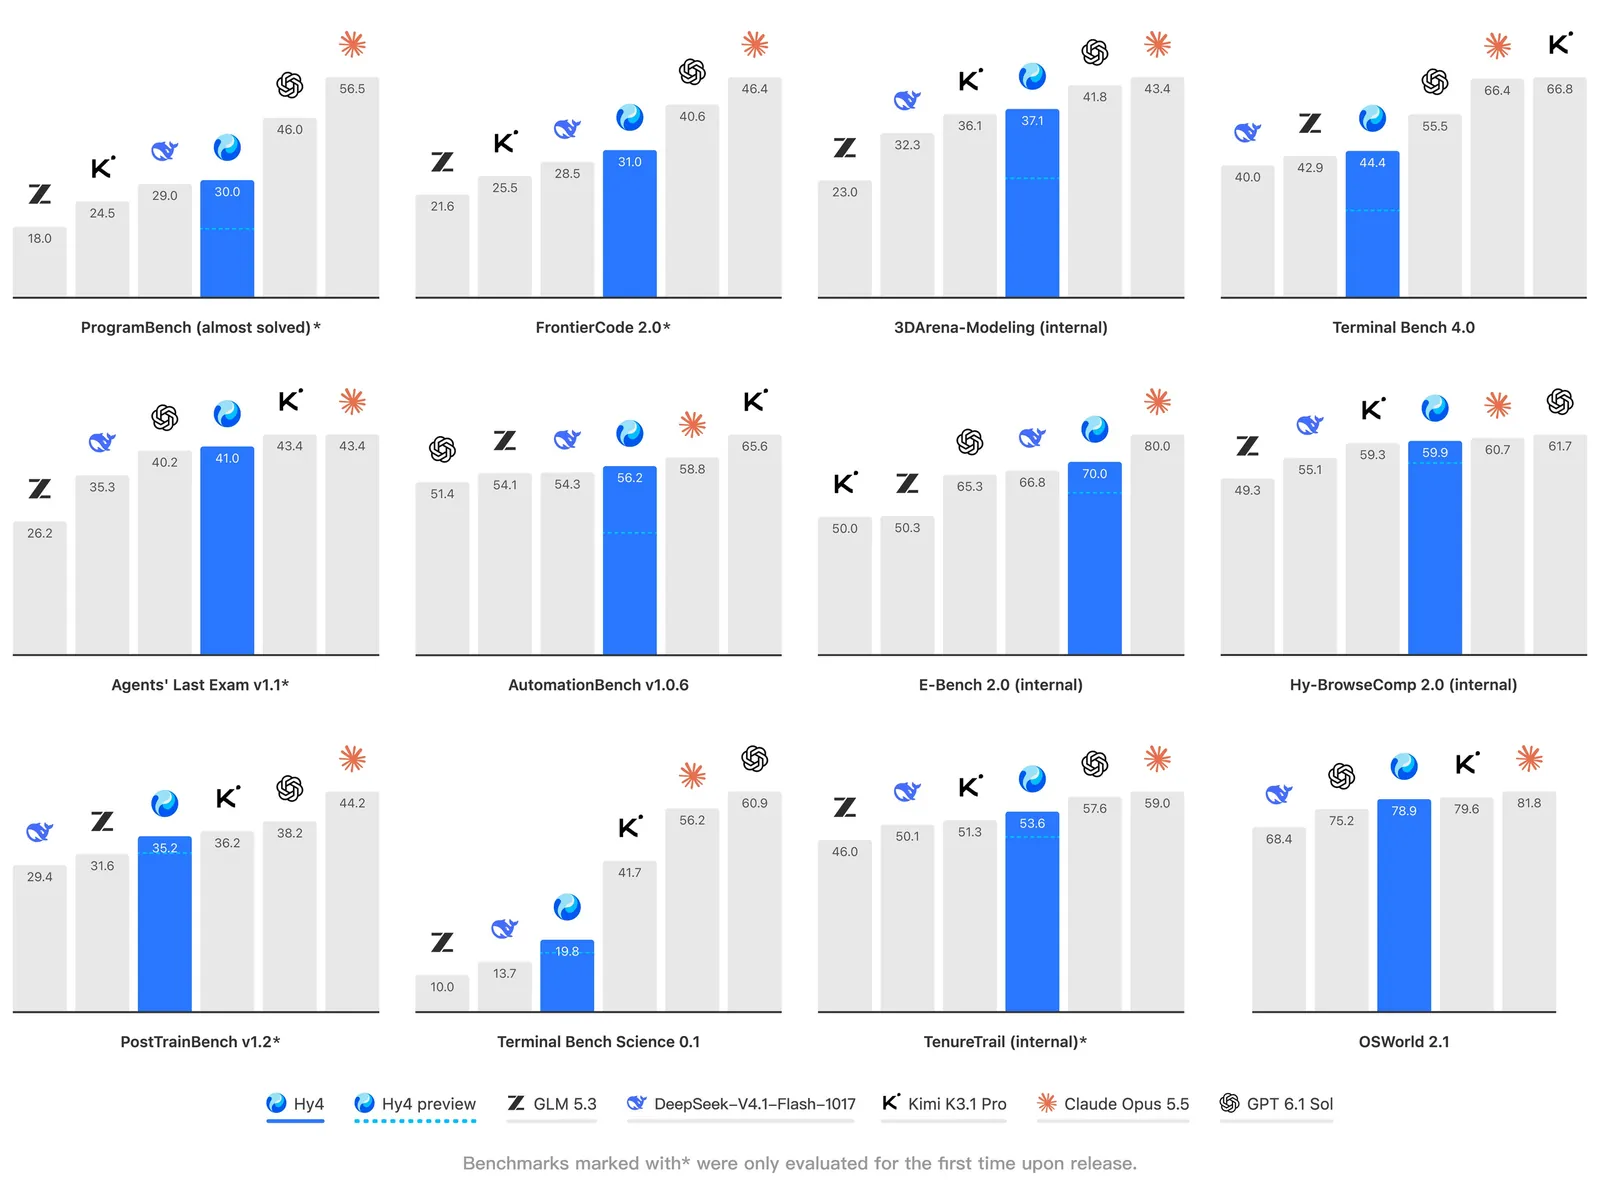
官方 34 項附錄:強項與短板都很清楚
發佈頁附錄列出約 34 項測試(DataLearner 完整轉載),全部在當時最高推理檔下測得。強項集中在 Agent 與電腦操作:DeepSWE v1.1 74.9(preview 64.3)、APEX-Agents v1.1 75.2(preview 53.9)、OSWorld 2.1 78.9、MMMU-Pro 78.6、AutomationBench v1.0.6 56.2(preview 36.3)、HLE-Full(帶工具)59.1。
短板同樣清楚,而且騰訊沒有藏:Hy-FrontierMath T5(內部數學測試)僅 13.0,GPT-6.1 Sol 是 97.5、Claude 91.3;Goal2Repo 23.2,Claude 74.0;Terminal-Bench-Science 19.8,GPT 60.9;BuddyVQA Atlas(無工具)55.6,Claude 75.3。SWE-Marathon v1.1 43.8 是在時限翻倍口徑下測的,讀的時候要注意條件。另有 ZeroBench-main 55.4、PostTrainBench 35.2、TenureTrail 53.6 等約 15 項內部評估,外部無法復現,只能當作騰訊自述。
獨立測量:AA 指數 35,中國第二
Artificial Analysis 在 11 月 5 日發佈獨立測量:智能指數 v5.0.1 爲 35 分,與 Grok 4.7(xhigh)持平,落後 Claude Haiku 5.5(max,36)1 分;中國實驗室中第二,僅次於 Kimi K3.1 Pro(46),領先 Qwen3.8 Max(45)與 DeepSeek V4.1 Flash(32.6)。AA 原話是同價位中低於平均(中位 41)。
AA 的分項測量值得細讀。FrontierCode 2.0 得 31%,是中國實驗室第一(DeepSeek 28%、Kimi 25%)。HLE-Diamond 33%。每任務成本約 $0.78,約爲同分 Grok 的 1/10。但 AA-Omniscience v1.1 給出準確率 50%、幻覺率 89%——Kimi 的幻覺率是 37%。注意準確率與幻覺率是兩個獨立指標,不要把 89% 理解成「89% 的回答是錯的」;AA 也未給出解釋。Agent Arena 上 Hy4 暫列第 13 名(排名 preliminary),騰訊稱開源模型中第一。
AA 還記錄了兩個工程特徵:Hy4「慢於平均、非常囉嗦」——評測中生成 1.6 億輸出 tokens,約爲中位數的兩倍;OpenRouter 上 P50 吞吐約 63 tok/s,P50 首 token 約 2.9 秒。便宜的任務成本有一部分會被囉嗦的輸出喫掉。
口徑陷阱:44.4% 與 37% 都是對的
Terminal-Bench 4.0 有兩個數,不要混用:官方 44.4%(Claude Code harness,最多 500 輪、每任務最多 13 小時)與 AA 實測 37%(AA 自有 harness)。兩者測試條件不同,都對,但不是同一個測試。同樣,Kimi K3.1 Pro 的 TB 4.0 在騰訊表內是 66.8%,在另一口徑下是 65.7%——引用時要註明來源。
還有一個數字要特別提醒:部分聚合裏流傳的 39.39%,其基準歸屬與測試 harness 不明,本頁不採納爲 TB 4.0 的分數。本站 Inkling 專題頁此前引用的 39.39% 亦需修正。
金融與辦公:騰訊組織的評估
FiT 金融衆測由騰訊組織,213 位專家(153 位外部)、579 項任務、4 分制:Hy4 3.04 分,開源第一,DeepSeek-V4.1-Flash-1017 2.97,Kimi 與 GLM 5.3 均爲 2.68。IRAB 評估(訊兔科技)顯示相對 preview 提升 12.03 分。WorkBuddy 辦公室評估平均 83.18 分、通過率 96.15%,12 個場景裏 9 箇中國第一。這些評估的組織方或數據源與騰訊有關,讀數時要打這個折扣。
參考來源:DataLearner — Tencent Hy4:評測、價格、API 與模型參數(本文爲本站改寫與整理,事實以官方來源與 Artificial Analysis 爲準)