Gemini 4 Hydrogen 基準測試全盤點:官方表、AA 51/54 分與 8% 幻覺率怎麼看
Hydrogen 發佈一天,分數已經不少:Google 的官方表、Artificial Analysis 的獨立測量、Vals 與 Agent Arena 的專項榜。但分數來自不同測試者、不同口徑,放在一起看會互相打架。本文把所有可覈查的分數列出來,並說明每一項是誰測的、跟誰比、能信幾分。
Google 官方表:三項領先,兩項落後
| 測試 | Hydrogen | Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|
| SWE-sweep | 13.5% | 3.1% | 5.8% |
| Terminal-Bench 4.1(作弊校正) | 57.0% | 63.9% | — |
| Agents' Last Exam v1.1 | 71.6% | 60.4% | 69.8% |
| AutomationBench-AA | 76.1% | 71.8% | 60.2% |
SWE-sweep 是領先幅度最大的一項:13.5% 對 Sonnet 5.5 的 3.1% 與 Terra 的 5.8%。但 Terminal-Bench 4.1 是官方表裏 Hydrogen 輸掉的一項:57.0% 對 Sonnet 5.5 的 63.9%。官方表由 Google 選定對照模型與測試版本——它願意把輸掉的那項也放進表裏,至少說明這張表不是隻挑贏的。
官方表的其他分數:OSWorld-2.1 77.6%(Sonnet 5.5 爲 83.9%,又輸一項);HLE-Diamond 58.8%(官方稱「同級領先」,但未指明同級包含哪些模型);Terminal-Bench-Science 0.1 51.4%;Vals Tax Agent Bench 52.3%(85 個模型中第 1);Vals Legal Research Bench 55.8%(並列第 1);Multimodal Knowledge Agent (MKA) 53.4%(同級領先);Agent Arena 第 5。與 3.8 Flash 對比:Terminal-Bench 4.1 從 18.2% 漲到 57%(high 檔,Google 每任務平均 5 次嘗試)。
AA 獨立測量:51/54 分與 8% 幻覺率
| 測量 | Hydrogen | 對照 |
|---|---|---|
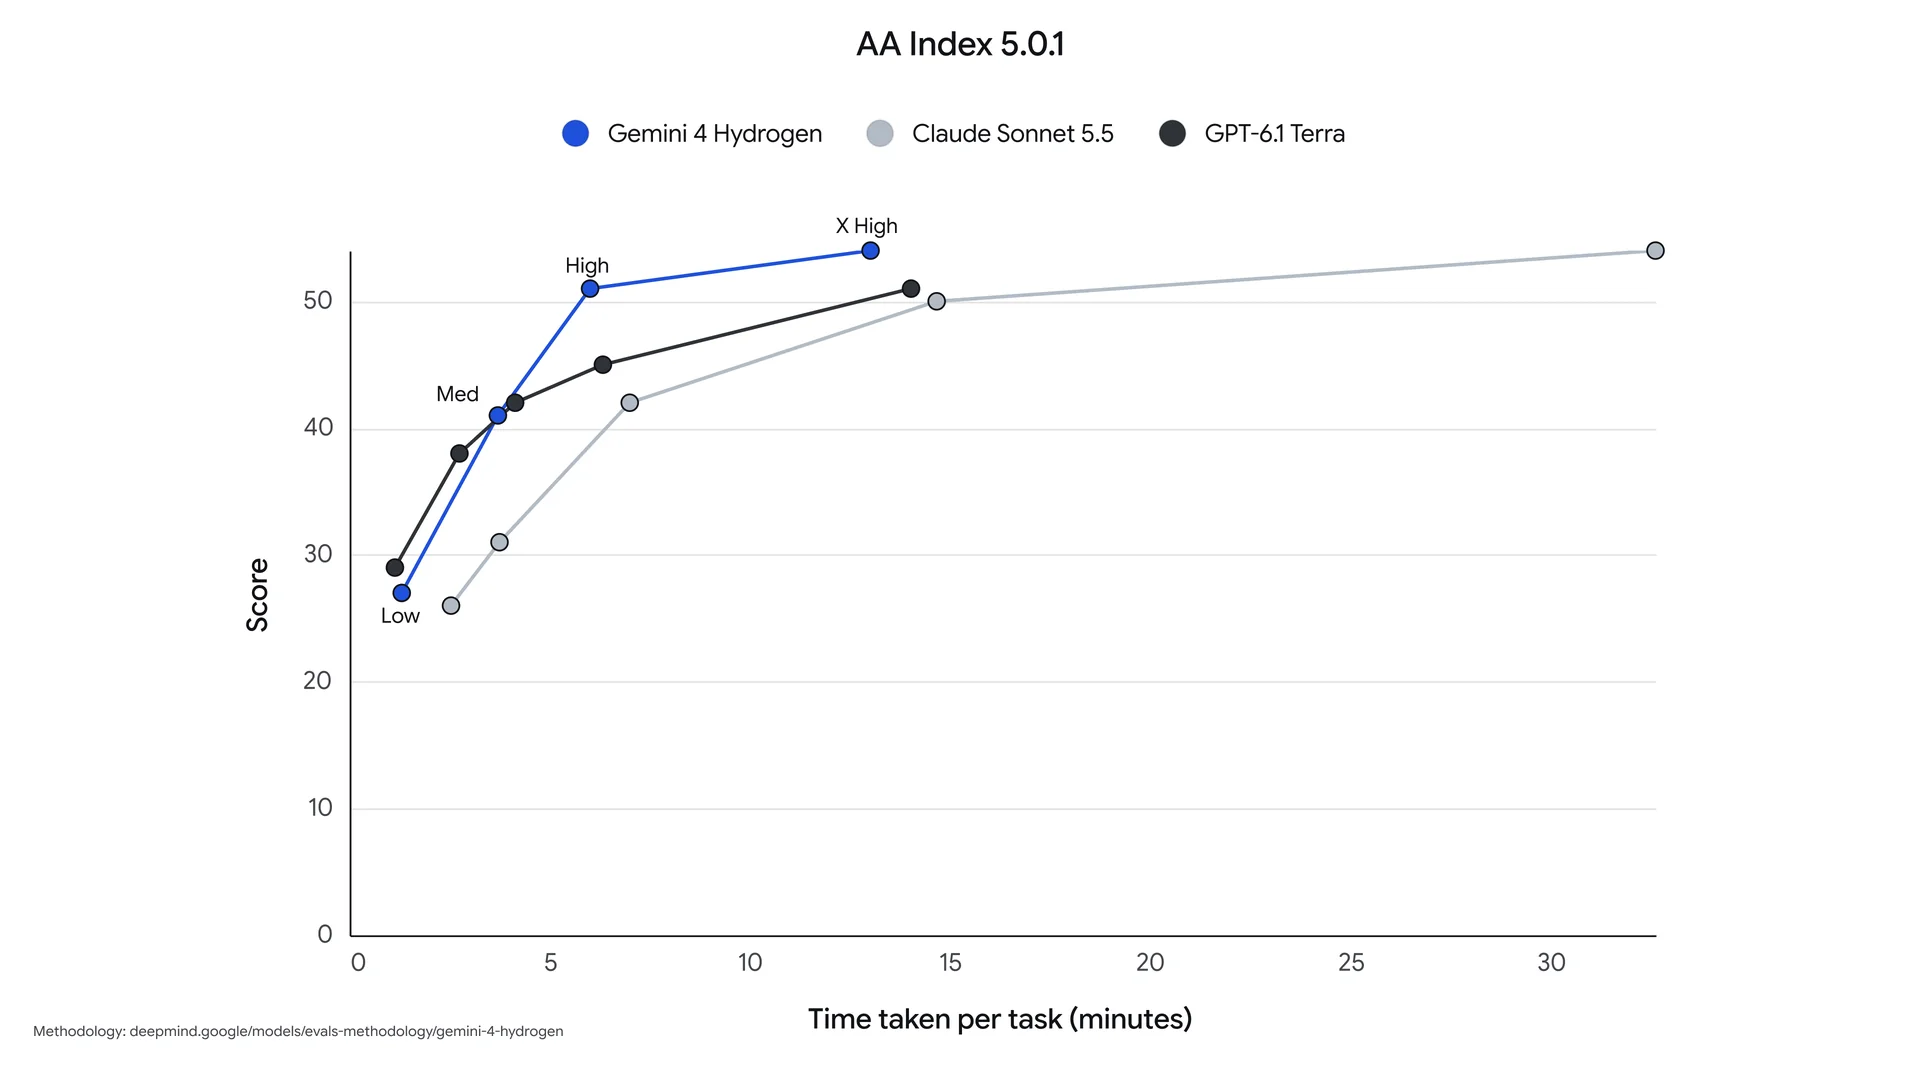
| AA 智能指數 v5.0.1(四檔) | low 27 / medium 41 / high 51 / xhigh 54 | Argon 50(high);Sonnet 5.5 與 Sol 各 55(max);Carbon 60(high) |
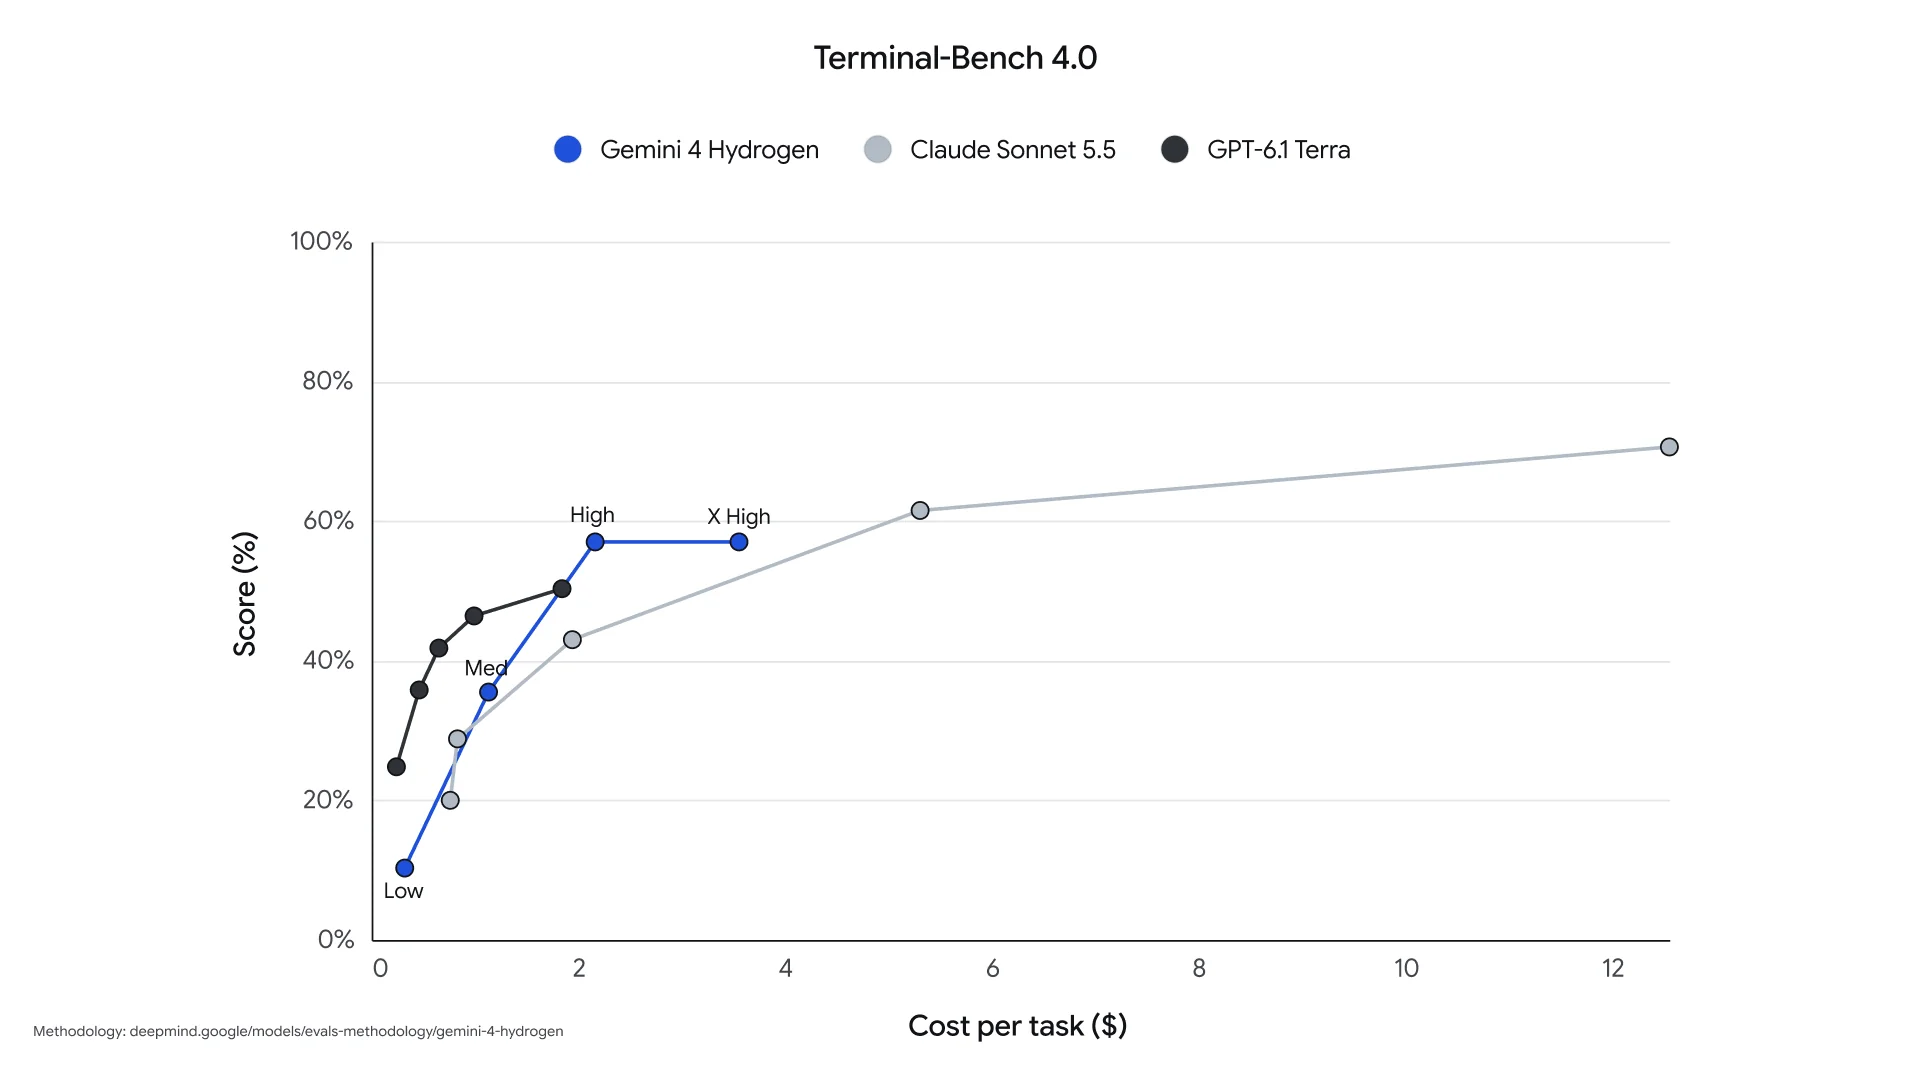
| 每任務成本 | low $0.29 / medium $0.80 / high $1.87 / xhigh $3.16 | xhigh 約 Sonnet 5.5(max)的 1/3,約 Sol(max)的 2.5 倍 |
| 每任務耗時 | high 約 6.0 分鐘;xhigh 約 13–14 分鐘 | AA 每 6 小時重跑,數字會浮動 |
| 首 token 等待(xhigh) | 約 41 秒 | 同類中位約 13.6 秒 |
| 輸出速度(xhigh) | 約 198 token/s | — |
| 指數運行總輸出 tokens | 304M | 同類中位 72.8M |
| AA-Omniscience 幻覺率 | 8% | Sonnet 5.5 43%;GPT-6.1 Sol 52% |
| Terminal-Bench 4.0(AA) | 54%(high 與 xhigh 相同),64 模型中第 11 | Sol 56%;Sonnet 5.5 64% |
| Terminal-Bench-Science 0.1(AA) | high 41% → xhigh 50% | Sonnet 5.5 53%(the-decoder) |
| AA-Briefcase / GDP.pdf | 展示質量高於其他 Gemini 模型(含 Carbon);GDP.pdf medium 檔並列最高 | — |
AA 的測量更可信,因爲測試者是第三方、方法公開、每 6 小時重跑。但要注意:AA 的數字會浮動——不同來源在不同時間讀到的每任務耗時就不一樣(xhigh 檔:winbuzzer 13.0 分鐘、stackfutures 13.5 分鐘、AA 模型頁 FAQ 13.7 分鐘)。本文寫的是約數,請以 AA 模型頁當前讀數爲準。
怎麼讀這些分數:六條 caveat
第一,官方表是 Google 自己挑的對手與版本。對照模型只有 Sonnet 5.5 與 Terra,沒有 Fable 5.2(AA 65 分的榜首);「同級領先」的同級也沒說清包含誰。
第二,Terminal-Bench 4.0 與 4.1 是兩個版本。AA 實測的 54% 是 4.0,官方表的 57% 是 4.1,對手與測法都不同,不能放進一句話裏比。
第三,Orchestrator 的基準版本至今未統一。Google 主博客稱 Terminal-Bench 4.0,Antigravity 官方帖稱 4.1,兩處自相矛盾,且均未給出具體成功率數字。
第四,安全類數字未指明比較對象。越權行爲減少 81%、服務不足減少 79%、Gray Swan 韌性提升 2.3 倍——cellcog 指出,這些句子都沒說跟誰比。
第五,HLE-Diamond 的對照分只有一處來源。Sonnet 5.5 的 53.3% 僅見於一處視頻轉述,本文未將其列入對照表。
第六,AA 的數字每 6 小時重跑。首 token 41.11 秒(11 月 12 日)與 40.55 秒(11 月 13 日)是同一指標的不同時點讀數;high 檔的首 token 數據 AA 未單列。
相關文章
參考來源:本文爲本站原創改寫與整理,事實與數據覈對自 deepmind.google Gemini 模型頁官方對比表與 Artificial Analysis 模型頁(2026-11-12/13)
← 返回 Gemini 4 Hydrogen 專題